In Kapitel 24 haben wir eine Antenne entworfen — und zwar wir: Wir kannten die Faustregeln (kurz führt, lang wirft zurück), wir haben Parameter durchgefahren, nachgestimmt, quergerechnet. Der Computer war dabei unser Messlabor, aber der Entwurf kam aus unserem Kopf. Dieses letzte Kapitel dreht den Spieß um. Wir sagen dem Computer nur noch, was das Bauteil können soll — „reflektiere diese Frequenz so stark wie möglich”, „lenke das Licht dorthin” — und lassen ihn selbst herausfinden, wie es aussehen muss. Das heißt inverses Design: Statt von der Struktur zur Wirkung zu rechnen (vorwärts, wie in 30 Kapiteln), suchen wir die Struktur zur gewünschten Wirkung.
Das ist keine Spielerei, sondern der Stand der Technik: Die kompaktesten optischen Strahlteiler, Wellenlängen- Sortierer und Modenwandler der Photonik stammen heute aus Optimierungs-Schleifen — winzige Pixel-Labyrinthe, auf die kein Mensch gekommen wäre, ein Vielfaches kleiner als ihre von Hand entworfenen Vorgänger. In diesem Kapitel bauen wir die Idee mit unseren eigenen Werkzeugen nach: Ein Optimierer aus SciPy wird den Bragg-Spiegel aus Kapitel 26 neu erfinden (und dabei einen Fehler korrigieren, den wir ihm absichtlich unterschieben), ein simples Probier-Verfahren wird in unserem Kapitel-9-FDTD-Gitter einen Strahl-Umlenker aus 36 Pixeln zusammenpuzzeln — und am Ende steht, wie es sich für ein letztes Kapitel gehört, ein Schlusswort.
Lernziele
Nach diesem Kapitel kannst du …
… den Unterschied zwischen Vorwärts-Simulation und inversem Design erklären und eine Zielfunktion formulieren,
… den Fluch der Dimensionen beziffern: warum Durchprobieren bei acht Parametern schon Jahrhunderte kostet und ein Optimierer mit rund tausend Auswertungen auskommt,
… ein Design-Problem mit scipy.optimize lösen und — wichtiger — das Ergebnis physikalisch lesen (der Optimierer entdeckt die λ/4-Regel, ohne sie zu kennen),
… erklären, warum lokale Optima Multistart erzwingen (die Zielfunktions-Landschaft hat viele Gipfel),
… ein Topologie-Puzzle per Hillclimbing lösen und weißt, warum invers entworfene Bauteile aussehen „wie gewachsen”,
… skizzieren, wie das Adjoint-Verfahren alle Ableitungen aus nur zwei Simulationsläufen gewinnt — und warum das die Topologie-Optimierung erst möglich macht.
31.1 Vorwärts, rückwärts, Zielfunktion
Alles, was wir in diesem Buch gebaut haben, war eine Vorwärts-Maschine: Struktur rein (Geometrie, Materialien), Wirkung raus (Reflexion, Richtdiagramm, Fokus). Inverses Design braucht genau eine Zutat mehr — eine einzige Zahl, die sagt, wie gut eine Wirkung ist: die Zielfunktion. Aus „reflektiere möglichst stark bei \(f_0\)” wird \(Z = R(f_0)\), aus „entspiegele das ganze sichtbare Band” wird \(Z = -\overline{R}_{400-700\,\text{nm}}\) (das Minus, weil Optimierer traditionell minimieren). Dann lautet die Aufgabe: Finde die Parameter, die \(Z\) optimal machen. Die Vorwärts-Maschine wird dabei vom Hauptdarsteller zum Hilfsarbeiter — sie wird hunderte Male aufgerufen, einmal pro Design-Kandidat.
Warum nicht einfach alles durchprobieren, wie beim Yagi-Sweep in Kapitel 24? Dort waren es zwei Parameter. Die Kosten des Durchprobierens wachsen aber exponentiell mit der Parameterzahl: acht Schichtdicken à zehn Testwerte sind schon \(10^8\) Simulationen, die 36 Ja/Nein-Pixel unseres Puzzles gleich \(2^{36} \approx 7
\cdot 10^{10}\) — bei einer Zehntelsekunde pro Lauf über 200 Jahre (Übung 31.1 rechnet nach). Das ist der Fluch der Dimensionen, und er ist der Grund, warum inverses Design ein eigenes Handwerk ist: Ein Optimierer tastet sich mit gezielten Auswertungen durch den Riesenraum — wir werden gleich sehen, dass er mit etwa tausend Aufrufen auskommt, wo der Sweep \(10^8\) bräuchte.
31.2 Der Computer erfindet den Spiegel
Unser erstes Design-Problem ist mit Absicht eines, dessen Lösung wir längst kennen — so können wir dem Optimierer auf die Finger schauen. Aus Kapitel 26 wissen wir: Der beste Spiegel aus zwei abwechselnden Glassorten ist der λ/4-Stapel — jede Schicht exakt eine viertel Wellenlänge dick (im jeweiligen Material), damit alle Teilreflexe in Phase aufeinanderfallen.
HinweisVorhersage (PRIMM)
Wir geben dem Optimierer acht Schichten (Materialfolge hoch/niedrig fest: \(n = 2{,}4\) und \(1{,}5\), wie in Kapitel 26), aber alle acht Dicken frei, mit zufälligen Startwerten. Die Zielfunktion ist schlicht: maximiere \(R(f_0)\). Was findet er — (a) irgendeinen krummen Kompromiss, schlechter als der λ/4-Stapel, (b) ziemlich genau den λ/4-Stapel, oder (c) etwas Besseres als unseren Plan?
Versuchsaufbau: Die Vorwärts-Maschine ist die Transfer-Matrix aus Kapitel 26 (acht Zeilen NumPy, unten als tmm_r). Der Optimierer ist scipy.optimize.minimize mit dem Nelder-Mead-Verfahren — ein robuster Kletterer, der keine Ableitungen braucht, sondern ein „Simplex” aus Testpunkten durch den Parameterraum wälzt. Weil solche Kletterer in Hügellandschaften am nächstgelegenen Gipfel hängen bleiben können, starten wir sechsmal von zufälligen Punkten (Multistart). Gemessen werden: das erreichte \(R(f_0)\) jedes Starts, die Zahl der Funktionsauswertungen — und dann sehen wir uns die gefundenen Dicken genau an. Erfolgskriterium: Die Physik muss im Ergebnis wiedererkennbar sein.
import matplotlib.pyplot as pltimport numpy as np# scipy.optimize.minimize: der Allzweck-Optimierer — sucht das Minimum# einer Funktion vieler Variablen; method= waehlt das Verfahrenfrom scipy.optimize import minimizeN_HI, N_LO =2.4, 1.5F0 =1.0# Designfrequenz (λ0 = 1)def tmm_r(ns, ds, f, n_sub=1.0):"""Reflexion |r|² eines Schichtstapels (Kap.-26-Transfer-Matrix).""" M = np.eye(2, dtype=complex)for n, d inzip(ns, ds): delta =2* np.pi * f * n * d M = M @ np.array([[np.cos(delta), -1j* np.sin(delta) / n], [-1j* n * np.sin(delta), np.cos(delta)]]) r = ((M[0, 0] + M[0, 1] * n_sub - M[1, 0] - M[1, 1] * n_sub)/ (M[0, 0] + M[0, 1] * n_sub + M[1, 0] + M[1, 1] * n_sub))returnabs(r) **2NS_BRAGG = np.array([N_HI, N_LO] *4) # Materialfolge festzaehler = {"n": 0} # zaehlt die Vorwaerts-Laeufedef kosten(ds): zaehler["n"] +=1return-tmm_r(NS_BRAGG, ds, F0) # Minus: minimize soll maximierenrng = np.random.default_rng(31)laeufe = []for start inrange(6): d0 = rng.uniform(0.02, 0.4, 8) # zufaellige Startdicken zaehler["n"] =0 res = minimize(kosten, d0, method="Nelder-Mead", options={"maxiter": 4000, "xatol": 1e-6, "fatol": 1e-9}) laeufe.append((-res.fun, res.x.copy(), zaehler["n"]))print(f"Start {start}: R = {-res.fun:.4f} "f"nach {zaehler['n']:4d} Auswertungen")
Start 0: R = 0.9595 nach 1500 Auswertungen
Start 1: R = 0.9595 nach 1144 Auswertungen
Start 2: R = 0.9595 nach  964 Auswertungen
Start 3: R = 0.9595 nach  798 Auswertungen
Start 4: R = 0.9595 nach  895 Auswertungen
Start 5: R = 0.9595 nach 1095 Auswertungen
Alle sechs Starts landen beim selben Wert — das Problem ist gutmütiger als befürchtet — und brauchen dafür jeweils um die tausend Auswertungen statt \(10^8\). Aber was haben sie gefunden? Schauen wir die Dicken des besten Laufs an. Eine Feinheit vorweg: In der Transfer-Matrix wirken zwei Dicken identisch, wenn sie sich um eine halbe Wellenlänge im Material unterscheiden (eine volle Extra-Hin-und-Her-Phase von \(2\pi\)) — physikalisch vergleichbar sind also die Dicken modulo\(\lambda/2n\):
Sieben der acht Dicken sind — modulo halber Wellenlänge — exakt λ/4n, auf vier Nachkommastellen. Der Optimierer hat die Kapitel-26-Regel wiederentdeckt, ohne je von Interferenz gehört zu haben; manche Schichten baut er als gleichwertige \(3\lambda/4\)-Fassung. Und die achte Schicht? Sie ist auf null kollabiert. Das ist kein Unfall, sondern Antwort (c) der Vorhersage:
ds7 = [1/ (4* n) for n in [N_HI, N_LO] *3+ [N_HI]]r7 = tmm_r([N_HI, N_LO] *3+ [N_HI], ds7, F0)r8 = tmm_r(NS_BRAGG, 1/ (4* NS_BRAGG), F0)print(f"unser 8-Schichten-Plan (endet niedrigbrechend): R = {r8:.4f}")print(f"7 Schichten, endet hochbrechend: R = {r7:.4f}")print(f"der Optimierer fand: R = {r_best:.4f}")
unser 8-Schichten-Plan (endet niedrigbrechend): R = 0.9111
7 Schichten, endet hochbrechend:                R = 0.9595
der Optimierer fand:                            R = 0.9595
Unser Bauplan hatte einen versteckten Fehler: Die Folge [hoch, niedrig] × 4 endet mit einer niedrigbrechenden Schicht zur Luft hin — und die schwächt den Spiegel, statt ihn zu stärken (ein guter Stapel endet hochbrechend; das steht so in jedem Optik-Lehrbuch, aber wir hatten es ihm nicht verraten). Der Optimierer hat die nutzlose Schicht kurzerhand wegoptimiert und aus unserem schlechten 8-Schicht-Plan den besten 7-Schicht-Spiegel gemacht: \(0{,}9595\) statt \(0{,}9111\).
WarnungNaheliegende Vermutung: „Der Computer findet nur, was man hineinsteckt“
Warum sie naheliegt: Wir haben die Materialfolge, die Schichtzahl und die Zielfunktion vorgegeben — wo soll da Raum für eine eigene „Idee” des Optimierers sein? Er dreht doch nur an den Knöpfen, die wir ihm hinhalten.
Was stattdessen stimmt: Innerhalb des Suchraums findet der Optimierer auch das, woran wir nicht gedacht haben — hier die Korrektur unseres Endschicht-Fehlers, in der Forschungspraxis ganze Bauformen, auf die kein Entwerfer gekommen ist (die Pixel-Labyrinthe der invers entworfenen Photonik). Die ehrliche Fassung der Vermutung lautet anders: Der Computer findet nur, was die Zielfunktion belohnt. Das ist die wahre Verantwortung des Design-Ingenieurs — wer „maximiere R bei genau \(f_0\)” bestellt, bekommt unter Umständen einen schmalbandigen, fertigungsempfindlichen Exoten (Übung 31.2 und 31.4 führen das vor). Die Kunst wandert vom Zeichenbrett in die Formulierung des Ziels.
Der Film zeigt die Erfindung im Zeitraffer: links die \(R(f)\)-Kurve des aktuellen Kandidaten, rechts die acht Dicken als Balken (mit der λ/4-Regel als Linien). Bevor du startest: Die Startdicken sind reiner Zufall — in welcher Reihenfolge wird Ordnung entstehen?
Die Spielwiese lässt dich selbst optimieren — mit dem einfachsten denkbaren Verfahren (zufällige kleine Änderungen, behalte jede Verbesserung), weil der Browser kein SciPy hat. Aufträge: (1) Reichen VERSUCHE = 300, um an die 0,96 heranzukommen? (2) Stelle N_SCHICHTEN = 12 — wie nah kommen die Balken an die roten λ/4-Linien?
31.3 Minimieren statt maximieren: der Antireflex-Belag
Dasselbe Werkzeug, umgekehrtes Ziel: Eine Glasoberfläche (Kapitel 6: \(R = 4\) %) soll über das ganze sichtbare Band möglichst wenig reflektieren — die Entspiegelung jeder Brille und jedes Objektivs. Jetzt darf der Optimierer neben zwei Dicken auch zwei Brechzahlen wählen (im realistischen Bereich 1,35 bis 2,4):
Von 4 Prozent auf 0,4 Promille im Bandmittel — Faktor vier unter der klassischen Einfachschicht aus Magnesiumfluorid. Auch hier lohnt das Lesen des Ergebnisses: Die erste Brechzahl klebt am unteren Rand des Erlaubten (1,35 — der Optimierer hätte gern noch weniger, aber so niedrigbrechende feste Materialien gibt es kaum; genau deshalb ist \(n = 1{,}38\) von MgF₂ in der Optik so wertvoll). Reale Objektiv-Vergütungen treiben das Spiel mit sechs bis acht Schichten weiter — entworfen mit genau dieser Methode.
31.4 Die Landschaft: warum Multistart Pflicht ist
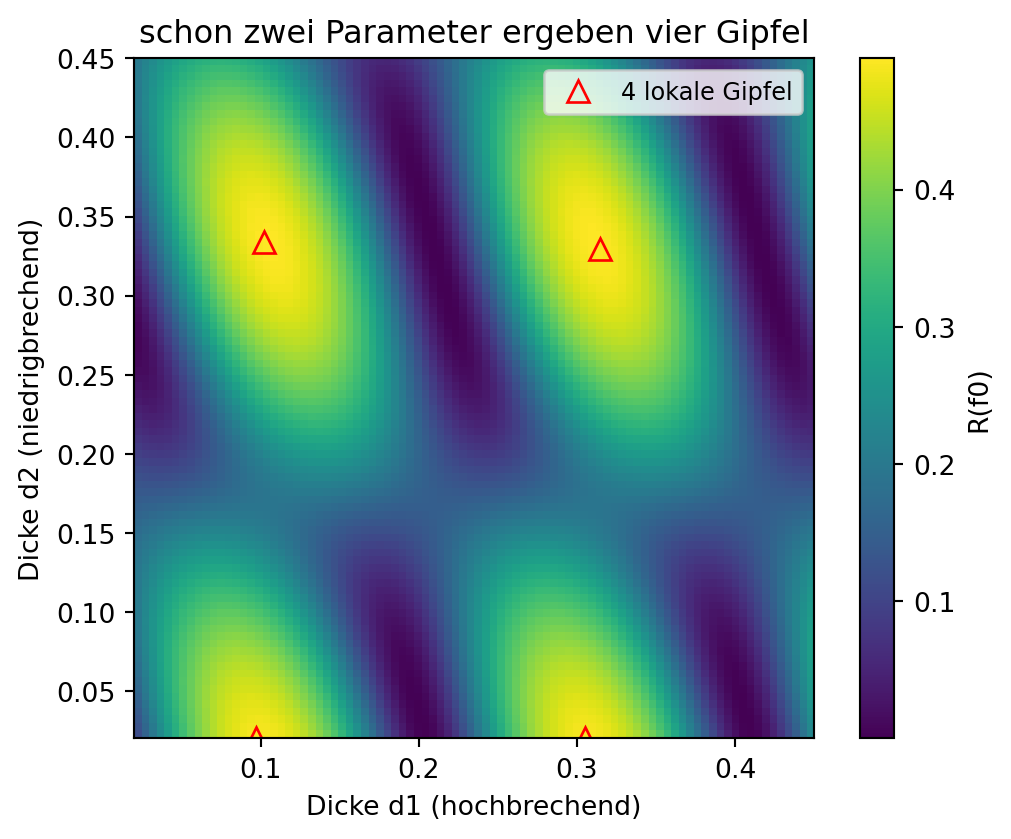
Dass alle sechs Bragg-Starts denselben Gipfel fanden, war Glück des Problems, nicht Eigenschaft des Verfahrens. Um zu sehen, womit Optimierer wirklich kämpfen, zeichnen wir die Zielfunktion einmal vollständig — das geht nur, wenn man sie auf zwei Parameter eindampft (genau deshalb ist diese Karte ein Luxus, den es ab drei Parametern nicht mehr gibt). Zwei Schichten, beide Dicken frei:
d1s = np.linspace(0.02, 0.45, 90)d2s = np.linspace(0.02, 0.45, 90)karte = np.array([[tmm_r([N_HI, N_LO], [d1, d2], F0) for d1 in d1s]for d2 in d2s])# scipy.ndimage.maximum_filter: ersetzt jeden Punkt durch das Maximum# seiner Umgebung — wo der Wert gleich bleibt, sitzt ein lokaler Gipfelfrom scipy.ndimage import maximum_filtergipfel = (karte == maximum_filter(karte, size=9)) & (karte >0.3)gj, gi = np.where(gipfel)fig, ax = plt.subplots(figsize=(6.2, 4.6))im = ax.imshow(karte, origin="lower", cmap="viridis", extent=[d1s[0], d1s[-1], d2s[0], d2s[-1]])ax.plot(d1s[gi], d2s[gj], "r^", ms=8, mfc="none", label=f"{gipfel.sum()} lokale Gipfel")ax.set_xlabel("Dicke d1 (hochbrechend)")ax.set_ylabel("Dicke d2 (niedrigbrechend)")ax.set_title("schon zwei Parameter ergeben vier Gipfel")ax.legend(fontsize=9)plt.colorbar(im, ax=ax, label="R(f0)")plt.show()
Abbildung 31.1: Die Zielfunktions-Landschaft R(d₁, d₂) für einen Zwei-Schicht-Spiegel: vier getrennte Gipfel (Dreiecke), getrennt durch tiefe Täler. Ein Bergsteiger-Verfahren landet auf dem Gipfel, in dessen Einzugsgebiet es startet — nur Multistart (oder Vorwissen) findet verlässlich den besten. Und die Gipfel-Positionen erzählen schon die Kapitel-Pointe: Die hochbrechende Dicke d₁ steht auf λ/4n (0,104) oder der gleichwertigen 3λ/4-Fassung (0,313) — die niedrigbrechende Schicht dagegen stellt sich UNSICHTBAR (d₂ ≈ 0 oder λ/2n = 0,333, eine volle Halbwellen-Schicht wirkt wie keine). Schon die Landschaft weiß: Eine niedrigbrechende Schicht zur Luft hin schadet dem Spiegel.
Vier Gipfel bei zwei Parametern — und die Gipfelzahl wächst mit jeder Dimension weiter. Ein lokales Verfahren (Nelder-Mead, Gradientenabstieg) klettert stur bergauf und endet auf dem Gipfel seines Startgebiets, der keineswegs der höchste sein muss. Die Standard-Gegenmittel hast du eben schon benutzt: Multistart (mehrfach zufällig starten, bestes Ergebnis nehmen) und Vorwissen (ein physikalisch motivierter Startpunkt — etwa „ungefähr λ/4” — startet meist im richtigen Tal).
In der Spielwiese kannst du den Bergsteiger auf dieser Karte aussetzen: Wähle den Startpunkt, der Rest ist ein simpler Gradienten-Aufstieg. Aufträge: (1) Starte bei \((0{,}05, 0{,}05)\) und bei \((0{,}30, 0{,}35)\) — landest du auf demselben Gipfel? (2) Lies die Positionen der vier Gipfel ab: Was haben alle gemeinsam — und was sagt die \(d_2\)-Koordinate über die niedrigbrechende Schicht?
31.5 Das Pixel-Puzzle: Topologie-Optimierung im Kleinen
Bisher hat der Optimierer an Maßen gedreht — die Bauform (ein Schichtstapel) stand fest. Die Königsklasse des inversen Designs geht einen Schritt weiter: Sie lässt auch die Form frei, indem sie den Bauraum in Pixel zerlegt und für jedes einzelne fragt: Material oder Luft? Das heißt Topologie-Optimierung, und wir bauen sie jetzt im Kleinformat — mit dem 2D-FDTD-Gitter aus Kapitel 9 als Vorwärts-Maschine, komplett selbst geschrieben.
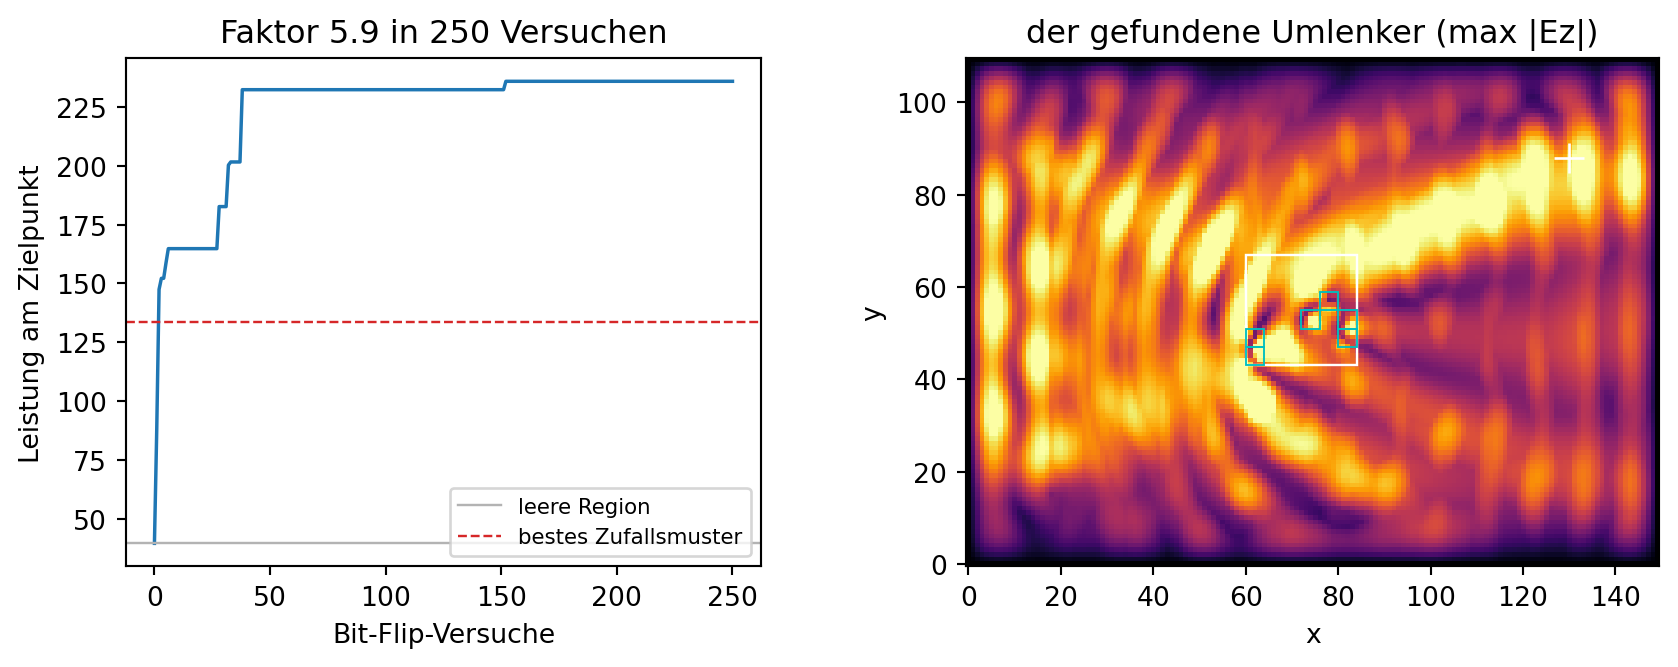
Versuchsaufbau: Die Frage: Kann ein dummes Probier-Verfahren aus 36 Ja/Nein-Pixeln ein optisches Bauteil zusammensetzen? Die Bühne: ein 150 × 110-Gitter (TMz wie in Kapitel 9, σ-Rampen als Rand), links eine CW-Linienquelle (\(\lambda = 20\) Zellen), in der Mitte die Design-Region — 6 × 6 Pixel à 4 × 4 Zellen, jedes entweder Luft (\(\varepsilon = 1\)) oder Material (\(\varepsilon = 6\)). Die Zielfunktion: die aufsummierte Leistung \(\sum E_z^2\) an einem Zielpunkt, der schräg versetzt hinter der Region liegt — geradeaus durchfliegen gilt nicht, das Licht muss umgelenkt werden. Der Optimierer ist diesmal absichtlich der einfachste der Welt: Bit-Flip-Bergsteigen — wirf eine Münze, welcher Pixel kippt, behalte den Flip, wenn das Ziel steigt, sonst nimm ihn zurück; 250 Versuche. Gemessen wird gegen zwei Referenzen: die leere Region und das beste von 20 Zufallsmustern. Erfolgskriterium: deutlich besser als beide.
NX, NY =150, 110DT =0.5F_TR =1/20.0NT =500RAND =10X_Q =18PIX, NPX, NPY =4, 6, 6X0, Y0 =60, 43# Ecke der Design-RegionZIEL = (130, 88) # der Zielpunkt: schräg oben rechtsEPS_HI =6.0# Daempfungs-Rampe an allen Raendern (die σ-Rampe aus Kapitel 9)sig = np.zeros((NX, NY))for i inrange(RAND): s =0.35* ((RAND - i) / RAND) **2 sig[i, :] = np.maximum(sig[i, :], s) sig[NX -1- i, :] = np.maximum(sig[NX -1- i, :], s) sig[:, i] = np.maximum(sig[:, i], s) sig[:, NY -1- i] = np.maximum(sig[:, NY -1- i], s)daempf = (1- sig * DT /2) / (1+ sig * DT /2)def bewerte(pixel, feld_zurueck=False):"""Ein 2D-FDTD-Lauf für ein Pixelmuster → Leistung am Zielpunkt.""" eps = np.ones((NX, NY))for i inrange(NPX):for j inrange(NPY):if pixel[i, j]: eps[X0 + i * PIX:X0 + (i +1) * PIX, Y0 + j * PIX:Y0 + (j +1) * PIX] = EPS_HI ez = np.zeros((NX, NY)) bx = np.zeros((NX, NY -1)) by = np.zeros((NX -1, NY)) summe =0.0 betrag = np.zeros((NX, NY))for n inrange(NT): rot_b = np.zeros((NX, NY)) rot_b[1:-1, 1:-1] = ((by[1:, 1:-1] - by[:-1, 1:-1])- (bx[1:-1, 1:] - bx[1:-1, :-1])) ez = daempf * ez + DT * rot_b / eps ez[X_Q, RAND +5:NY - RAND -5] += np.sin(2* np.pi * F_TR * n * DT) bx -= DT * np.diff(ez, axis=1) by += DT * np.diff(ez, axis=0)if n >150: # erst einschwingen lassen summe += ez[ZIEL] **2if feld_zurueck: betrag = np.maximum(betrag, np.abs(ez))return (summe, betrag) if feld_zurueck else summeleer = bewerte(np.zeros((NPX, NPY), bool))pixel = np.zeros((NPX, NPY), bool)wert = leerverlauf = [wert]flips = [] # Protokoll fuer den Filmfor it inrange(250): i, j = rng.integers(0, NPX), rng.integers(0, NPY) pixel[i, j] =~pixel[i, j] neu = bewerte(pixel)if neu > wert: wert = neu flips.append((it, pixel.copy(), wert))else: pixel[i, j] =~pixel[i, j] # Flip zuruecknehmen verlauf.append(wert)# Referenz: 20 zufaellige Muster# rng.random: gleichverteilte Zahlen in [0,1) — mit "> 0.5" wird daraus# ein zufaelliges Ja/Nein-Musterzufall_best =max(bewerte(rng.random((NPX, NPY)) >0.5) for _ inrange(20))print(f"leer: {leer:6.1f}")print(f"Zufall (beste von 20): {zufall_best:6.1f}")print(f"Bergsteigen: {wert:6.1f} → Faktor {wert / leer:.1f} gegen leer")
leer:             39.7
Zufall (beste von 20):  133.7
Bergsteigen:     235.8  → Faktor 5.9 gegen leer
250 dumme Münzwürfe schlagen das beste von zwanzig Zufallsmustern deutlich — nicht weil ein einzelner Versuch klug wäre, sondern weil behalten und verwerfen Information akkumuliert. So sieht das gefundene Bauteil bei der Arbeit aus:
Abbildung 31.2: Das Pixel-Puzzle: Links der Optimierungs-Verlauf — jede Treppenstufe ist ein behaltener Bit-Flip; die graue Linie ist die leere Design-Region, die rote das beste von 20 Zufallsmustern. Rechts das gefundene Bauteil bei der Arbeit (Karte: max |Ez|): Die Welle kommt von links, die cyan umrandeten Pixel sind Material (ε = 6), und am weißen Kreuz — dem Zielpunkt, schräg versetzt — sammelt sich das Licht. Das Muster wirkt zusammengewürfelt, lenkt aber nachweislich Faktor 6 mehr Leistung dorthin als die leere Region: invers entworfene Bauteile sehen aus „wie gewachsen“, nicht wie konstruiert.
Halte einen Moment inne bei diesem Bild: Niemand hat dieses Muster entworfen. Es ist entstanden — aus einer Zielvorgabe, einer Vorwärts-Maschine und 250 Münzwürfen. Es nutzt vermutlich eine Mischung aus Brechung, Streuung und Interferenz, die sich gegen unsere Intuition sperrt — und genau das ist typisch: Invers entworfene Photonik sieht aus wie Flechtwerk oder Korallen, nicht wie Linsen und Spiegel. Lesbarkeit war nie das Ziel; nur die Zielfunktion zählt.
Der Film spielt die Entstehung ab — links wächst die Treppe, rechts kippen die Pixel. Achte darauf, wie selten am Ende noch ein Flip behalten wird: Das Bergsteigen nähert sich seinem lokalen Gipfel.
Unser Bergsteigen ist ehrlich, aber verschwenderisch: Jeder einzelne Münzwurf kostet eine volle Simulation, und bei den Millionen Pixeln echter Topologie-Optimierung ist das hoffnungslos. Die Profis gehen mit Gradienten bergauf — sie wissen für jeden Pixel gleichzeitig, ob mehr oder weniger Material das Ziel verbessert. Naiv gemessen (jeden Parameter einzeln anstupsen, Differenzenquotient) kostet der Gradient \(N + 1\) Simulationen pro Schritt — bei \(N\) Pixeln wieder hoffnungslos.
Der Ausweg ist ein Satz, der zu den elegantesten der numerischen Physik gehört: das Adjoint-Verfahren. Es liefert den vollständigen Gradienten — alle \(N\) Ableitungen — aus genau zwei Simulationen: dem normalen Vorwärts-Lauf und einem zweiten Lauf, bei dem eine Ersatzquelle am Zielpunkt sitzt und das Feld rückwärts durch dieselbe Struktur schickt. Aus dem Überlapp beider Felder an jedem Ort folgt, wie empfindlich das Ziel auf Material genau dort reagiert. Dass „rückwärts durch dieselbe Struktur” überhaupt wohldefiniert ist, verdankt sich der Zeitumkehr-Symmetrie der Maxwell-Gleichungen aus Kapitel 20 — die dort eine philosophische Pointe war und hier zum Arbeitstier wird. Zwei Läufe statt \(N + 1\): Erst dieser Faktor macht Design-Räume mit Millionen Freiheitsgraden begehbar, und jedes ernsthafte Photonik-Designwerkzeug (auch Meep bringt ein Adjoint-Modul mit, siehe Kleingedrucktes) hat ihn eingebaut.
Damit ist die Landkarte komplett: Zielfunktion formulieren, Vorwärts-Maschine wählen (TMM, FDTD, NEC — was zur Physik passt), Optimierer dazu (gradientenfrei für wenige Parameter, Adjoint-Gradienten für viele), Multistart gegen lokale Gipfel, und am Ende — das zeigt Übung 31.4 — ein Robustheits-Check gegen Fertigungstoleranzen, denn der nominell beste Entwurf ist nicht immer der gutmütigste. Der Mensch ist dabei nicht arbeitslos geworden; seine Arbeit ist gewandert: vom Zeichnen der Struktur zum Formulieren des Ziels und zum kritischen Lesen des Ergebnisses. Beides erfordert genau das, was dieses Buch aufgebaut hat — physikalisches Urteilsvermögen.
31.7 Das Kapitel-Programm
programme/kap31/kap31_inverses_design.py bündelt alle Befunde eigenständig und mit assert-Schranken: die Bragg-Erfindung (sechs Starts, λ/4-Regel modulo λ/2n, kollabierte Endschicht, 7-gegen-8-Schichten-Kontrolle), das Antireflex-Design, die Landschafts-Karte mit ihren vier Gipfeln, das Pixel-Puzzle (Faktor > 4 gegen leer, besser als 20 Zufallsmuster) und den Robustheits-Check aus Übung 31.4. Reines NumPy/SciPy mit fester Zufalls-Saat; Laufzeit etwa eine Minute.
TippMerkkasten
Inverses Design: Ziel statt Struktur vorgeben — eine Zielfunktion macht aus „gut” eine Zahl, der Optimierer ruft die Vorwärts-Maschine als Unterprogramm.
Fluch der Dimensionen: Sweep-Kosten wachsen exponentiell (\(10^8\) für 8 Parameter à 10 Werte); Optimierer kommen mit ~10³ gezielten Auswertungen aus.
Ergebnisse lesen: Der Optimierer entdeckt physikalische Regeln (λ/4) und Plan-Fehler (nutzlose Endschicht) — aber er belohnt nur, was die Zielfunktion bestellt. Die Verantwortung wandert in die Ziel-Formulierung.
Lokale Gipfel: Schon zwei Parameter ergeben vier Maxima → Multistart oder physikalisch motivierte Startpunkte.
Topologie-Optimierung: Bauraum in Pixel zerlegen; selbst Bit-Flip-Bergsteigen findet funktionierende Bauteile („wie gewachsen”). Skalierbar wird das erst durch das Adjoint-Verfahren: alle \(N\) Ableitungen aus zwei Läufen (vorwärts + Ersatzquelle am Ziel rückwärts — die Kapitel-20-Zeitumkehr als Werkzeug).
Robustheit: Designs auf flachen Maxima (Bragg) verzeihen Fertigungsfehler; Designs auf Nullstellen (Antireflex) leben von der Präzision — nominal bester ≠ bester.
Roter Faden
Das letzte Kapitel erntet das ganze Buch: Die Transfer-Matrix aus Kapitel 26 und das 2D-Yee-Gitter aus Kapitel 9 wurden als Vorwärts-Maschinen eingespannt, der Zufallsgenerator aus Kapitel 10/30 wurde zum Optimierer, die λ/4-Physik aus Kapitel 22/26 kam als Prüfstein zurück (der Optimierer musste sie wiederfinden), die Zeitumkehr aus Kapitel 20 wurde im Adjoint-Verfahren zum Rechenwerkzeug, und der Yagi-Entwurf von Hand aus Kapitel 24 bekam sein Gegenstück: den Entwurf aus der Zielfunktion. Damit schließt sich der Kreis dieses Buchs — vom Sehen der Felder über das Verstehen und Nachbauen bis zu dem Punkt, an dem der Computer selbst zu entwerfen beginnt und unsere Aufgabe das Urteilen wird.
Übungen
Ü 31.1 — Der Fluch, beziffert (Verstehen). (a) Unser Pixel-Puzzle hat 36 binäre Pixel und braucht 0,1 s pro Bewertung. Wie lange dauert das vollständige Durchprobieren aller Muster? (b) Wie viele Bewertungen hat unser Bergsteigen gebraucht — und welchen Anteil des Suchraums hat es damit gesehen? (c) Acht Schichtdicken à 100 Testwerte, 1 ms pro TMM-Lauf: Sweep-Dauer?
HinweisMusterlösung zu Ü 31.1
sekunden =2.0**36*0.1print(f"(a) 2^36 Muster × 0,1 s = {sekunden:.2g} s "f"= {sekunden /3.15e7:.0f} Jahre")print(f"(b) 250 Bewertungen = {250/2.0**36:.1e} des Suchraums")print(f"(c) 100^8 × 1 ms = {100.0**8*1e-3/3.15e7:.1e} Jahre")
(a) 2^36 Muster × 0,1 s = 6.9e+09 s = 218 Jahre
(b) 250 Bewertungen = 3.6e-09 des Suchraums
(c) 100^8 × 1 ms = 3.2e+05 Jahre
Rund 220 Jahre — für ein Spielzeugproblem mit 36 Pixeln. (b) Das Bergsteigen sah vier Milliardstel des Suchraums und fand trotzdem ein Bauteil mit Faktor 6 — Optimierung ist keine Abkürzung durchs Probieren, sondern ein anderes Spiel. (c) \(3 \cdot 10^5\) Jahre: Der „harmlose” Acht-Parameter-Sweep ist längst jenseits jeder Rechenzeit. Genau deshalb war der Kapitel-24-Sweep auf zwei Parameter beschränkt — und genau hier übernehmen Optimierer.
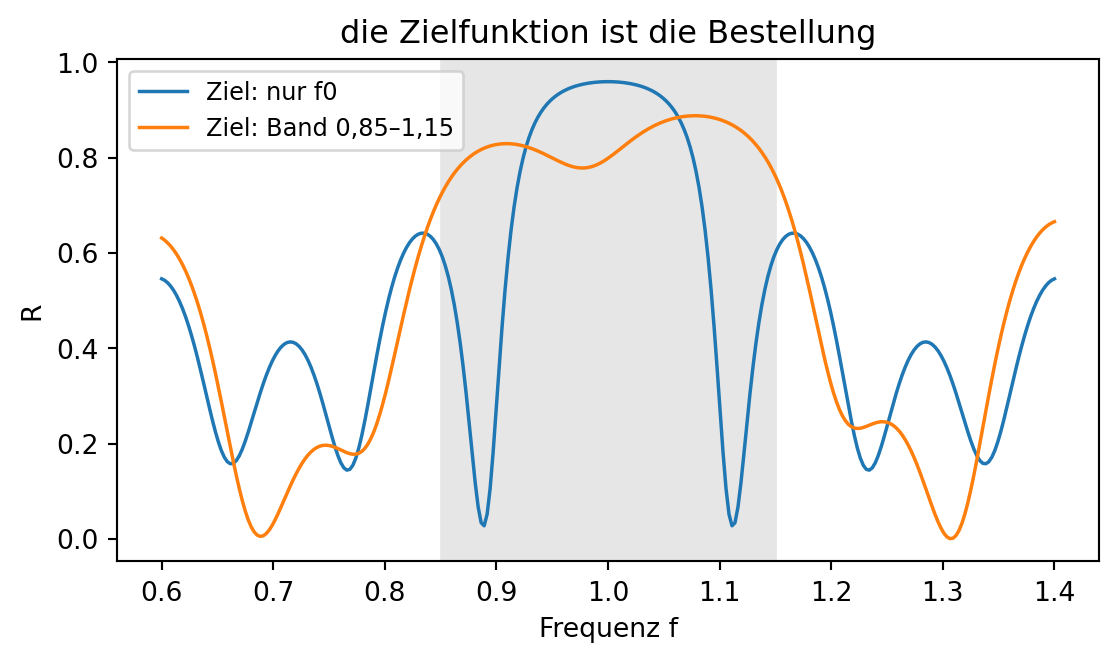
Ü 31.2 — Bestelle breit (Verändern). Der Kapitel-Spiegel wurde nur bei \(f_0\) bestellt. Ändere die Zielfunktion auf das mittlere\(R\) über das Band \(f = 0{,}85\) bis \(1{,}15\) und optimiere erneut (Multistart!). (a) Wie ändern sich die gefundenen Dicken? (b) Vergleiche \(R(f_0)\) und die Bandbreite beider Designs — was hat der Breitband-Spiegel bezahlt?
HinweisMusterlösung zu Ü 31.2
fs_breit = np.linspace(0.85, 1.15, 21)def kosten_band(ds):return-np.mean([tmm_r(NS_BRAGG, ds, f) for f in fs_breit])best_band =Nonefor s inrange(4): res = minimize(kosten_band, rng.uniform(0.02, 0.4, 8), method="Nelder-Mead", options={"maxiter": 4000})if best_band isNoneor res.fun < best_band.fun: best_band = resd_band = best_band.xprint(f"(a) Banddicken mod λ/2n: "f"{np.round(np.mod(d_band, 1/ (2* NS_BRAGG)), 3)}")print(f" (λ/4n wäre: {np.round(1/ (4* NS_BRAGG), 3)})")print(f"(b) R(f0): schmal {tmm_r(NS_BRAGG, d_best, F0):.4f}, "f"breit {tmm_r(NS_BRAGG, d_band, F0):.4f}")print(f" R-Mittel im Band: schmal "f"{-kosten_band(d_best):.4f}, breit {-best_band.fun:.4f}")fs_plot = np.linspace(0.6, 1.4, 300)fig, ax = plt.subplots(figsize=(6.6, 3.4))ax.plot(fs_plot, [tmm_r(NS_BRAGG, d_best, f) for f in fs_plot], "C0-", lw=1.3, label="Ziel: nur f0")ax.plot(fs_plot, [tmm_r(NS_BRAGG, d_band, f) for f in fs_plot], "C1-", lw=1.3, label="Ziel: Band 0,85–1,15")ax.axvspan(0.85, 1.15, color="0.9")ax.set_xlabel("Frequenz f")ax.set_ylabel("R")ax.set_title("die Zielfunktion ist die Bestellung")ax.legend(fontsize=9)plt.show()
Schmal bestellt gegen breit bestellt: Das nur bei f₀ optimierte Design (blau) erreicht dort die höchste Reflexion (0,96), fällt aber außerhalb schnell ab. Das auf das Band 0,85–1,15 optimierte Design (orange, Band grau hinterlegt) hält die Reflexion über das ganze Band oben — und bezahlt dafür deutlich am Gipfel (0,80 bei f₀). Die Zielfunktion ist die Bestellung: Wer nur einen Punkt bestellt, bekommt einen Spezialisten.
Die inneren Dicken bleiben nahe der λ/4-Familie, aber gegeneinander verstimmt, und die Randschichten scheren ganz aus (eine kollabiert wieder auf null) — der Optimierer spannt mit der Verstimmung das Band auf (dasselbe Prinzip treiben „gechirpte” Spiegel für ultrakurze Laserpulse auf die Spitze, deren Schichtdicken systematisch anwachsen). (b) Der Preis ist deutlich: Am Gipfel \(f_0\) fällt \(R\) von \(0{,}96\) auf \(0{,}80\) — dafür steigt das Band-Mittel von \(0{,}66\) auf \(0{,}82\). Ein klassischer Zielkonflikt: Beide Designs sind „optimal” — für verschiedene Bestellungen.
Ü 31.3 — Der Strahlteiler (Übertragen). Ändere im Pixel-Puzzle die Zielfunktion: Statt eines Zielpunkts gibt es jetzt zwei (z. B. schräg oben und schräg unten, symmetrisch), und das Ziel ist das Minimum der beiden Leistungen (damit der Optimierer keinen Punkt bevorzugt). Lass das Bergsteigen laufen. Teilt das gefundene Muster den Strahl?
Leistung oben 138.2 / unten 139.8 (leer war oben 39.7)
min(beide) = 138.2 — gegen leer: Faktor 3.5
Das Min-Ziel zwingt den Optimierer zur Fairness: Er kann nicht einen Punkt mästen und den anderen verhungern lassen — heraus kommt ein Muster, das beide Zielpunkte über das Leer-Niveau hebt, ein Strahlteiler aus Münzwürfen. (Die erreichten Werte liegen unter denen des Einzelziel-Umlenkers — die Leistung wird ja geteilt.) Genau mit solchen Mehrziel-Funktionen — oft als Minimum oder gewichtete Summe — entstehen die realen Wellenlängen-Sortierer der Photonik.
Ü 31.4 — Der Robustheits-Check (Übertragen). Kein Fertigungsprozess trifft Dicken exakt. Verrausche (a) den gefundenen 7-Schicht-Bragg und (b) das Antireflex-Design aus diesem Kapitel mit ±5 % gleichverteiltem Dickenfehler (Monte-Carlo, 300 Züge wie in Kapitel 30) und vergleiche Mittelwert und Streuung der Güte mit dem Nominalwert. Welches Design ist gutmütiger — und warum?
Der Bragg verliert durch ±5 % Dickenfehler praktisch nichts (−0,0006 im Mittel): Sein Optimum ist ein flaches Maximum — die erste Ableitung ist dort null, kleine Fehler wirken nur quadratisch nach unten von einem hohen Wert. Das Antireflex-Design verschlechtert sich relativ um rund acht Prozent: Seine Güte ist eine Nullstelle der Reflexion, und von null aus gibt es nur eine Richtung — jede Abweichung kostet sofort. Die allgemeine Lektion: Wer invers entwirft, sollte die Toleranz-Statistik in die Zielfunktion holen (etwa das mittlere \(R\) über das Fertigungs-Ensemble minimieren statt das nominale) — die Profis nennen das robust design, und unsere Kapitel-30-Monte-Carlo-Technik ist das Werkzeug dazu.
Das Kleingedruckte
Meeps Adjoint-Modul und die Werkzeug-Welt. Meep bringt mit meep.adjoint eine vollwertige Topologie-Optimierung mit: Design-Regionen mit kontinuierlichem \(\varepsilon\) pro Pixel, automatische Gradienten über das Adjoint-Verfahren (intern braucht es die Pakete autograd und nlopt, die in unserer Umgebung nicht installiert sind — daher die Eigenbau-Route dieses Kapitels). Die kommerziellen Photonik-Werkzeuge (Lumerical, Tidy3D) haben Adjoint ebenso eingebaut wie die Mechanik-Welt ihre Topologie-Löser. Wer den Einstieg sucht: Die Meep-Dokumentation enthält durchgerechnete Adjoint-Beispiele (Modenwandler, Linsen, Demultiplexer) in genau der Python-Sprache, die du aus diesem Buch kennst.
Eine kurze Geschichte der gewachsenen Bauteile. Die Topologie-Optimierung stammt aus der Mechanik: Martin Bendsøe und Ole Sigmund entwickelten in den 1990ern die Verfahren, mit denen heute Flugzeug-Halterungen und Hüftimplantate „wachsen” — Material nur dort, wo Lastpfade es brauchen, knochenartig verästelt. In die Photonik kam die Methode um 2004 (Jensen/Sigmund) und wurde durch die Gruppe um Jelena Vučković in Stanford berühmt: Ihr invers entworfener Wellenlängen-Demultiplexer von 2015 — ein Quadrat von 2,8 µm Kantenlänge, das zwei Farben in zwei Wellenleiter sortiert — wurde zur Ikone des Felds und ist um Größenordnungen kleiner als jede klassische Lösung. Heute kommen Beschleuniger-auf-dem-Chip-Strukturen, Freiform-Metaoberflächen und ganze Kamera-Objektive aus solchen Schleifen.
Das Adjoint-Verfahren, eine Stufe genauer. Die saubere Herleitung läuft über Lagrange-Multiplikatoren: Man hängt die Maxwell-Gleichungen als Nebenbedingung an die Zielfunktion und erhält ein „adjungiertes” Feld, das von einer aus der Zielfunktion abgeleiteten Quelle erzeugt wird — sitzt das Ziel an einem Punkt, ist die Adjoint-Quelle ein Dipol an genau diesem Punkt. Der Gradient bezüglich \(\varepsilon(\vec{r})\) ist dann (bis auf Konstanten) das Produkt aus Vorwärtsfeld und Adjoint-Feld am selben Ort. Dass der adjungierte Maxwell-Operator bis auf Zeitumkehr derselbe ist wie der ursprüngliche (Reziprozität!), macht den zweiten Lauf zu einer gewöhnlichen FDTD-Simulation — deshalb bekommt man das Verfahren in jeden bestehenden Löser eingebaut. Dieselbe Mathematik trägt übrigens das Training neuronaler Netze: „Backpropagation” ist das Adjoint-Verfahren der Lernmaschinen, und die Zeitumkehr-Läufe aus Kapitel 20 waren näher an der modernen KI, als es damals aussah.
Fertigung als Nebenbedingung. Reale invers entworfene Bauteile müssen herstellbar sein: minimale Strukturgrößen (eine Lithografie-Maschine kann keine 10-nm-Inseln drucken), Verbote freischwebender Material-Inseln, Binärisierung (am Ende muss jeder Pixel Material oder Luft sein, nicht 37 % dazwischen). Die Praxis erzwingt das über Filter (das Design wird vor der Bewertung geglättet) und Projektionen (weiche Übergänge werden im Lauf der Optimierung zunehmend hart geschaltet) — und über genau die Robustheits-Ziele aus Übung 31.4, oft als Optimierung über drei Kopien gleichzeitig: nominal, überätzt, unterätzt.
Schlusswort: die Reise
Auf der ersten Seite dieses Buchs stand ein Pfeilbild — ein elektrisches Feld, das man ansehen kann. Dreißig Kapitel später hat ein Computer eigenständig ein optisches Bauteil entworfen, und dazwischen lag ein einziger durchgehender Weg: vier Gleichungen. Alles, was uns begegnet ist — die Stehwelle im 1D-Labor und der Regenbogen im Prisma, der Knick in der Antennenleitung und das Doppelbild im Kalkspat, das Tunneln durchs Verbotene und das Photon, das würfelt —, war Maxwell, nur immer wieder anders befragt. Wenn dieses Buch eine einzige Überzeugung hinterlässt, dann diese: Die Elektrodynamik ist kein Katalog von Phänomenen, sondern ein Gedanke mit unerschöpflichen Konsequenzen.
Das zweite, was bleiben soll, ist eine Arbeitsweise. Wir haben in jedem Kapitel dasselbe Ritual geübt: erst vorhersagen, dann messen, dann die Abweichung ernst nehmen — denn fast immer wohnte dort die eigentliche Physik (der Sockel an der Dipol-Speisung, die fehlenden 0,8 % in der Energiebilanz, die Etalon-Echos der Wellenplatte). Dazu die Handwerksregeln, die sich durch alle Werkstattkästen zogen: Traue keiner Simulation ohne Theorielinie im Bild, keiner einzelnen Auflösung, keinem Ergebnis, das du nicht auf einem zweiten Weg bestätigen kannst — und wenn ein etabliertes Problem zickt, lies nach, bevor du rätst. Diese Regeln sind nicht an Meep gebunden und nicht an die Elektrodynamik; sie sind das übertragbare Kapital dieses Buchs, und sie gelten in jedem Feld, in dem Rechnungen Wirklichkeit vorhersagen sollen.
Und der Eigenbau? Wir haben den Leapfrog-Kern in Kapitel 5 aus sechs Zeilen NumPy gebaut und hätten ab Kapitel 11 bequem alles Meep überlassen können. Dass wir es nie ganz getan haben, war Absicht: Jedes Mal, wenn etwas Rätselhaftes geschah — Felder explodierten, Phasen liefen rückwärts, eine PML verstärkte statt zu dämpfen —, war es der Blick in den selbstgebauten Kern, der das Rätsel löste. Werkzeuge, deren Inneres man einmal selbst verdrahtet hat, bleiben durchschaubar, wenn sie sich seltsam verhalten. Das gilt für FDTD wie für alles andere, was du in deinem Werkzeugkasten trägst.
Wie weiter? Am besten mit einer eigenen Frage — der Playground neben diesem Buch ist genau dafür da, und jedes „was passiert, wenn …” ist ein legitimer Forschungsauftrag. Wer tiefer in die Theorie will, findet in Griffiths’ Introduction to Electrodynamics den nächsten Schritt und in den Feynman Lectures (Band II, frei im Netz) die schönste Physik-Prosa, die es gibt; für die Numerik ist Taflove/Hagness die FDTD-Bibel, für photonische Kristalle Joannopoulos (frei im Netz), für Wellen und Antennen Orfanidis (ebenfalls frei). Und die Werkzeuge dieses Buchs — Meep, NEC, NumPy — sind quelloffen und werden von Gemeinschaften gepflegt, denen man beitreten kann: Fragen stellen, Beispiele teilen, Fehler melden. Wissenschaft ist ein Mannschaftssport.
James Clerk Maxwell hat seine Gleichungen 1865 veröffentlicht, zwischen Pferdekutschen und Gaslaternen, und niemand — er selbst eingeschlossen — konnte ahnen, dass darin Radio und Radar, Glasfaser und WLAN, Laser und Kernspintomograf schon enthalten waren. Richard Feynman urteilte hundert Jahre später, vom amerikanischen Bürgerkrieg werde neben dieser Entdeckung wenig übrig bleiben — „the most significant event of the 19th century”. Die Gleichungen sind heute 160 Jahre alt und keinen Tag müde; du hast in diesem Buch gesehen, dass vier Zeilen Vektoranalysis genügen, um Licht zu brechen, zu speichern, rückwärts laufen zu lassen und von einem Computer verbauen zu lassen, der sie als Zielfunktion liest.
Was du damit baust, ist neu. Viel Freude dabei.
(Und wer nach dem Schlussakkord noch nicht gehen mag: Es gibt eine Zugabe. Kapitel 32 nimmt die Gleichungen mit in die Werkstatt — als Schall.)