Wer schon einmal mit einem FEM-Werkzeug, einem Schaltungssimulator wie SPICE oder einem Statik-Programm gearbeitet hat, kennt den heiligen Dreiklang der numerischen Simulation: Matrix aufstellen, Gleichungssystem lösen, Ergebnis ablesen. Riesige dünnbesetzte Matrizen, clevere Löser, Speicher als Engpass — so sieht „richtige” Simulation aus.
Nur: In den Kapiteln 5 und 6 haben wir komplette Wellenphysik simuliert, und da war — nichts davon. Keine Matrix, kein Löser, nur zwei Zeilen np.diff. Haben wir heimlich doch ein Gleichungssystem gelöst, gut versteckt in NumPy? Oder geht Simulation auch ohne — und wenn ja, was unterscheidet dann unsere Methode von denen, die tatsächlich lösen? Dieses Kapitel zieht die Trennlinie scharf: Sie heißt explizit gegen implizit, und auf beiden Seiten stehen Verfahren mit sehr verschiedenen Stärken.
Lernziele
Nach diesem Kapitel kannst du …
… die Update-Schleife als Matrix-Vektor-Produkt\(v^{n+1} = A\,v^n\) schreiben und numerisch belegen, dass beides dasselbe ist,
… erklären, warum ein explizites Verfahren dabei kein Gleichungssystem löst — und woran man eines erkennt, das es tut,
… das implizite Crank–Nicolson-Verfahren aufstellen und sehen, wo dort das Gleichungssystem tatsächlich entsteht,
… die Eigenschaften beider Welten vorführen: CFL-Explosion bei \(S > 1\), unbedingte Stabilität implizit — und warum stabil nicht genau heißt,
… begründet wählen: Welches Verfahren für welches Problem?
7.1 Die Schleife, als Matrix gelesen
Zuerst eine Vereinfachung, die sich doppelt auszahlt: Wir messen das Magnetfeld ab jetzt in der Größe \(u = c \cdot B\) — sie hat dieselbe Einheit wie \(E\) (Volt pro Meter; in den Plots von Kapitel 5 haben wir das stillschweigend schon getan). Damit schrumpfen die beiden Update-Zeilen aus Kapitel 5 auf einen einzigen Koeffizienten zusammen — die Courant-Zahl\(S = c\,\Delta t/\Delta x\):
u -= S * np.diff(e) # der B-Schritte[1:-1] -= S * np.diff(u) # der E-Schritt
Beide Zeilen tun dasselbe: Sie bilden Nachbar-Differenzen und ziehen sie gewichtet ab. „Nachbar-Differenzen bilden” ist eine lineare Operation — und jede lineare Operation auf einem Vektor lässt sich als Matrix schreiben. Wie diese Matrix aussieht, zeigt am schnellsten ein winziges Gitter:
import numpy as npimport matplotlib.pyplot as plt# scipy.sparse: Matrizen, die nur ihre Nicht-Null-Einträge speichernimport scipy.sparse as spfrom scipy.constants import cdef differenzmatrix(m):"""(m−1) × m: Zeile i bildet die Nachbar-Differenz f[i+1] − f[i]."""# sp.diags(werte, lagen): legt Werte auf Diagonalen — hier −1 auf# die Hauptdiagonale (Lage 0) und +1 auf die Nebendiagonale (Lage 1)return sp.diags([-np.ones(m -1), np.ones(m -1)], [0, 1], shape=(m -1, m), format="csr")D6 = differenzmatrix(6)# .toarray(): macht aus der sparse-Matrix ein gewöhnliches Arrayprint(D6.toarray())
Lies eine Zeile von Hand: Zeile 2 hat \(-1\) in Spalte 2 und \(+1\) in Spalte 3, also liefert sie \((D e)_2 = e_3 - e_2\) — exakt der dritte Eintrag von np.diff(e). Die ganze Matrix istnp.diff, aufgeschrieben als Tabelle. Und weil ein kompletter Zeitschritt nur aus solchen Differenzen und Additionen besteht, lässt sich der gesamte Schritt als eine Matrix \(A\) schreiben, die auf den Zustandsvektor \(v = (e_0, \dots, e_{N-1},\, u_0, \dots, u_{N-2})\) wirkt:
\[
v^{\,n+1} \;=\; A \, v^{\,n},
\qquad
A = \begin{pmatrix} I + S^2\,G D & -S\,G \\[2pt] -S\,D & I \end{pmatrix},
\]
wobei \(D\) die Differenzen der \(e\)-Werte bildet und \(G\) die der \(u\)-Werte (mit Nullzeilen am Rand — unsere Metallwände). Der \(S^2\)-Block entsteht, weil der E-Schritt das schon aktualisierte \(u\) benutzt. Ob die Behauptung stimmt, prüfen wir nicht per Algebra, sondern per Experiment — Matrix gegen Schleife, 100 Schritte:
# von oben: differenzmatrix(), sp; c (Import)N =1201DX =0.01X = np.arange(N) * DXdef matrizen(s, n=N):"""Schritt-Matrix A und Crank–Nicolson-Paar (L, R) zur Courant-Zahl s.""" d = differenzmatrix(n)# sp.vstack: stapelt Matrizen übereinander (hier: Nullzeilen als Rand) g = sp.vstack([sp.csr_matrix((1, n -1)), differenzmatrix(n -1), sp.csr_matrix((1, n -1))], format="csr")# sp.bmat: setzt eine Matrix aus Blöcken zusammen a = sp.bmat([[sp.identity(n) + s**2* (g @ d), -s * g], [-s * d, sp.identity(n -1)]], format="csr") m = sp.bmat([[sp.csr_matrix((n, n)), -s * g], [-s * d, sp.csr_matrix((n -1, n -1))]], format="csr") i = sp.identity(2* n -1, format="csr")return a, (i - m /2).tocsc(), (i + m /2).tocsr()def startzustand(): e = np.exp(-((X -6.0) /0.5)**2)# np.concatenate: hängt Arrays aneinander — e und u in EINEM Vektorreturn np.concatenate([e, np.zeros(N -1)])def leapfrog_schritt(v, s):"""Der Schleifencode aus Kapitel 5/6, in u = c·B-Schreibweise.""" e, u = v[:N].copy(), v[N:].copy() u -= s * np.diff(e) e[1:-1] -= s * np.diff(u)return np.concatenate([e, u])A, L, R = matrizen(1.0)v_schleife, v_matrix = startzustand(), startzustand()for _ inrange(100): v_schleife = leapfrog_schritt(v_schleife, 1.0) v_matrix = A @ v_matrixprint(f"max. Abweichung Schleife vs. Matrix: "f"{np.max(np.abs(v_schleife - v_matrix)):.1e}")print(f"A speichert {A.nnz:,} Einträge — von {(2*N-1)**2:,} möglichen "f"({A.nnz/(2*N-1)**2*100:.2f} %)")
max. Abweichung Schleife vs. Matrix: 4.7e-15
A speichert 9,597 Einträge — von 5,764,801 möglichen (0.17 %)
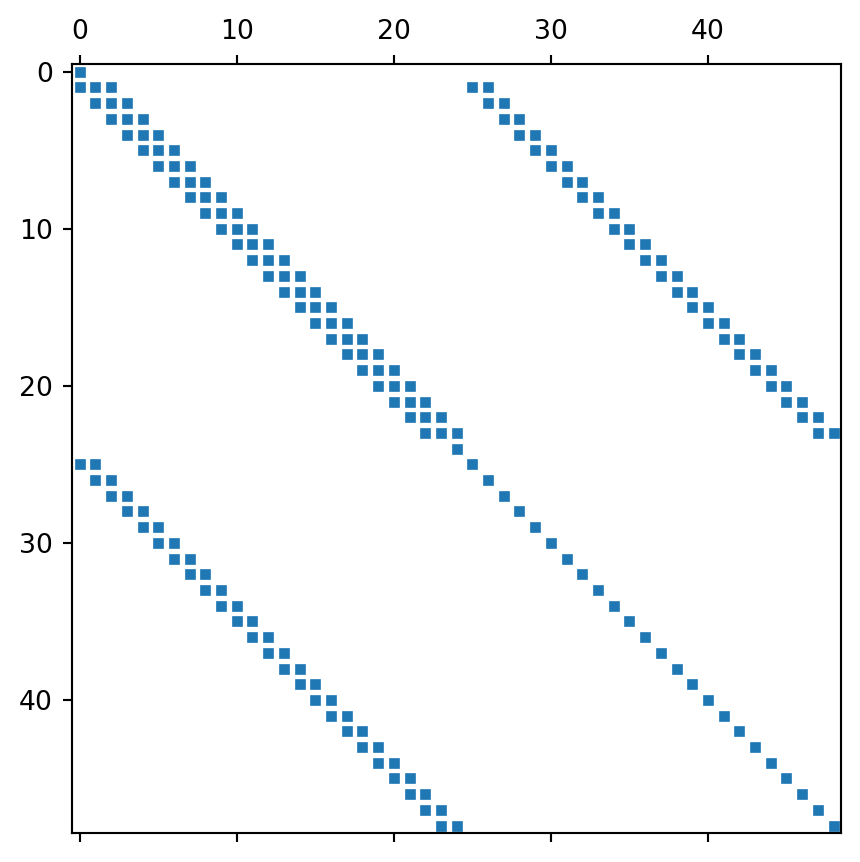
Identisch bis auf Rundungsreste — Schleife und Matrix sind dasselbe Verfahren in zwei Schreibweisen. Und die Matrix ist extrem dünnbesetzt (englisch sparse): Von 5,8 Millionen möglichen Einträgen sind nur 0,17 % von null verschieden, weil jeder Gitterwert nur mit seinen unmittelbaren Nachbarn spricht. So sieht sie aus:
# von oben: matrizen()A_klein, _, _ = matrizen(1.0, n=25)fig, ax = plt.subplots(figsize=(4.6, 4.6))ax.spy(A_klein, markersize=3) # spy: zeichnet die Nicht-Null-Einträgeplt.tight_layout(); plt.show()
Abbildung 7.1: Die Schritt-Matrix A für ein kleines Gitter mit 25 Punkten (jeder Punkt = ein Nicht-Null-Eintrag). Links oben der e-Block, rechts unten der u-Block; die schmalen Bänder sind die Nachbar-Differenzen — alles andere ist null, denn jeder Punkt spricht nur mit seinen Nachbarn.
WarnungNaheliegende Vermutung
Vermutung:„Ein Differenzenverfahren stellt aus den Gleichungen ein lineares Gleichungssystem auf und löst es — irgendwo in NumPy steckt also doch ein Löser.”
Warum sie naheliegt: Für weite Teile der Simulationswelt stimmt es. FEM-Programme, Schaltungssimulatoren, Statik-Löser, Strömungslöser — sie alle stellen Systeme auf und lösen sie. Und eine Matrix haben wir ja nun tatsächlich gefunden.
Was stattdessen stimmt: Es kommt darauf an, auf welcher Seite der Gleichung die Unbekannte steht. Unser Schritt lautet \(v^{n+1} = A\,v^n\) — die Unbekannte \(v^{n+1}\) steht allein links, rechts stehen nur bekannte alte Werte. Das ist eine Auswertung (multiplizieren, fertig), kein Gleichungssystem. Verfahren dieser Bauart heißen explizit. Ein Gleichungssystem entsteht erst, wenn die Unbekannte auf beiden Seiten auftaucht — etwa \(L\,v^{n+1} = R\,v^n\) mit einer Matrix \(L\) vor der Unbekannten, die man nicht trivial wegdividieren kann. Solche Verfahren heißen implizit, und eines bauen wir jetzt.
7.1.1 „Auswertung” heißt: alle Punkte gleichzeitig
Der Satz „rechts stehen nur bekannte alte Werte” hat eine sehr praktische Konsequenz, und sie erklärt rückwirkend, warum unser Code seit Kapitel 5 so aussieht, wie er aussieht. Wenn jeder neue Wert nur aus alten Werten berechnet wird, dann hängt kein neuer Eintrag von einem anderen neuen Eintrag ab. Ob du zuerst e[1] ausrechnest oder zuerst e[1000], von links nach rechts oder rückwärts — das Ergebnis ist identisch, denn die Punkte reden während des Updates nicht miteinander. Mathematisch werden alle Gitterpunkte gleichzeitig aktualisiert; jede Reihenfolge ist nur eine Abarbeitungs-Bequemlichkeit.
Genau deshalb durfte die Raumschleife von Anfang an in NumPy verschwinden. Ausgeschrieben wäre ein FDTD-Lauf eine Doppelschleife — außen die Zeit, innen der Ort:
for n inrange(schritte): # Zeit: MUSS nacheinander laufenfor i inrange(1, N -1): # Raum: dürfte auch parallel laufen e[i] = e[i] - s * (u[i] - u[i -1])
Die innere Schleife ist reihenfolgefrei, also darf NumPy sie als eine Array-Operation ausführen (np.diff plus elementweise Verrechnung) — dieselbe Rechnung, nur ohne Python-Umweg pro Punkt; auf einer Grafikkarte würden die Punkte buchstäblich parallel rechnen. Die äußere Schleife dagegen kann niemand wegoptimieren: Schritt \(n+1\) braucht das Ergebnis von Schritt \(n\) — die Zukunft lässt sich nicht parallel zur Gegenwart berechnen. Von der Doppelschleife bleibt darum genau eine echte Schleife übrig, das for n in range(...) der Zeit; alles andere ist Matrix mal Vektor.
Eine Sorgfaltsstelle gibt es doch — und sie betrifft nicht die Reihenfolge innerhalb eines Arrays, sondern die Frage, welchen Zeitstand eine Zeile liest. Vergleiche die beiden Verfahren aus Kapitel 5:
def leapfrog_schritt(e, b): # KEINE Kopien — mit Absicht: b -= ... np.diff(e) # b springt zuerst, e[1:-1] -= ... np.diff(b) # und e liest das FRISCHE b!def euler_schritt(e, b): # Kopien — ebenfalls mit Absicht: e_neu, b_neu = e.copy(), b.copy() e_neu[...] = ... # beide Zeilen lesen die b_neu[...] = ... # ALTEN Felder e und b
Beim Leapfrog ist das Lesen des frisch aktualisierten b kein Schlamperei-Risiko, sondern das Verfahren selbst: Genau dadurch liegt das benutzte B zeitlich einen halben Schritt vor dem E — der Bockspringer-Versatz aus dem Yee-Schema in Kapitel 5. Der Euler-Gleichschritt dagegen definiert sich darüber, dass beide Felder aus demselben alten Zeitstand schreiten — darum die .copy()-Zeilen: Ohne sie läse die zweite Zeile das schon aktualisierte Feld der ersten, und aus dem Gleichschritt würde unbemerkt ein halb versetztes Verfahren. Der ganze Unterschied zwischen den beiden Bauplänen steckt also buchstäblich in der Frage „Kopie oder frisches Feld?“. (NumPy nimmt dir dabei eine Falle ab: Innerhalb einer Zuweisungszeile wird die komplette rechte Seite ausgewertet, bevor irgendetwas geschrieben wird — halbfertige Mischstände innerhalb eines Arrays kann es gar nicht geben.)
Und damit ist auch klar, was gleich anders wird: Beim impliziten Verfahren hängen die neuen Werte voneinander ab — der neue e[5] steht in derselben Gleichung wie der neue e[4] und der neue e[6]. Dann gibt es kein „alle gleichzeitig, Reihenfolge egal” mehr, elementweises NumPy hilft nicht weiter, und genau deshalb braucht jeder Zeitschritt jetzt einen Gleichungslöser.
7.2 Die andere Philosophie: Crank–Nicolson
Warum sollte jemand die Unbekannte freiwillig auf beide Seiten stellen? Aus einem ehrenwerten Motiv: Symmetrie in der Zeit. Unser expliziter Schritt wertet die Änderungsrate aus den alten Feldern aus. Das Verfahren von Crank–Nicolson (CN) nimmt stattdessen den Mittelwert aus alter und neuer Änderungsrate — die Trapezregel, angewandt auf die Zeit:
mit \(M\) als der Matrix der Änderungsraten (unsere zwei Differenzen-Blöcke mal \(S\)). Jetzt steht \(v^{n+1}\) wirklich auf beiden Seiten: Jeder Zeitschritt ist ein Gleichungssystem mit \(2N-1\) Unbekannten. Der Lohn dieser Mühe ist beachtlich — und ihr Preis auch. Beides zeigt ein Doppel-Experiment:
WichtigVorhersage-Punkt
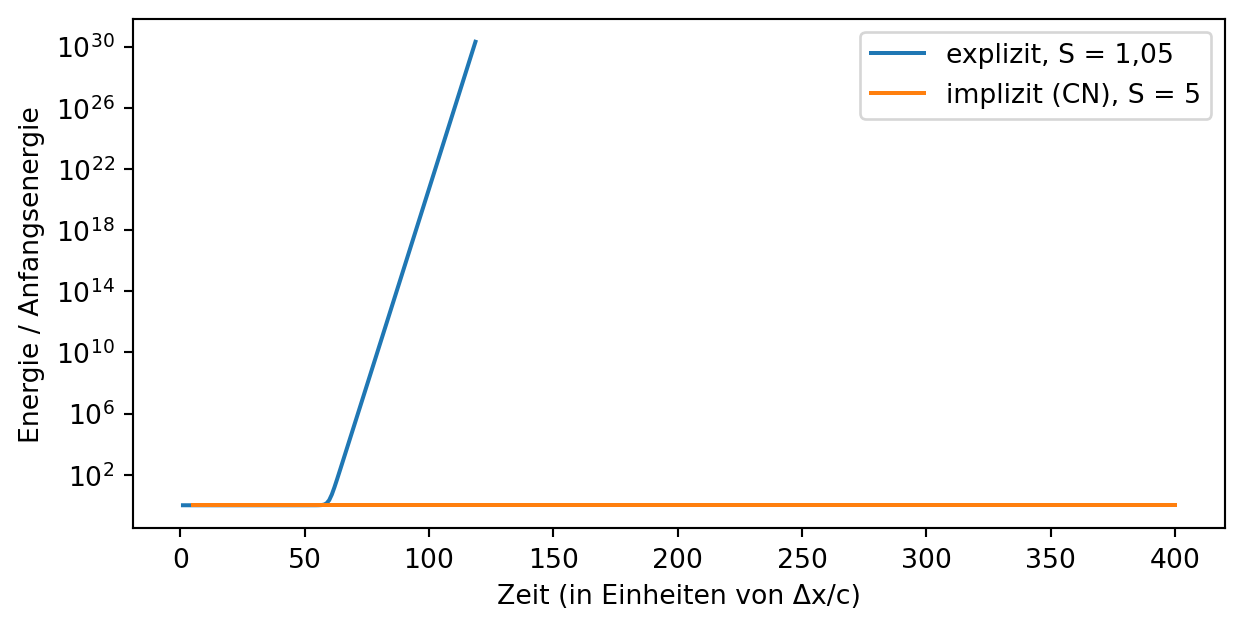
Bevor du die Zelle liest: Wir lassen erstens den expliziten Schritt mit \(S = 1{,}05\) laufen — nur 5 % über dem „magischen” Zeitschritt. Und zweitens Crank–Nicolson mit \(S = 5\) — dem fünffachen. Was erwartest du für die beiden Energiekurven?
# von oben: matrizen(), startzustand()# scipy.sparse.linalg.splu: zerlegt L EINMAL (LU-Faktorisierung);# danach kostet jedes lu.solve(b) nur noch Vorwärts-/Rückwärts-Einsetzenfrom scipy.sparse.linalg import splue0 = np.sum(startzustand()**2)A_schnell, _, _ = matrizen(1.05)v = startzustand()verlauf_explizit = []for _ inrange(600): v = A_schnell @ v verlauf_explizit.append(np.sum(v**2) / e0)if verlauf_explizit[-1] >1e30:break_, L5, R5 = matrizen(5.0)lu5 = splu(L5)v = startzustand()verlauf_cn = []for _ inrange(80): # 80 Schritte à S=5 = 400 Zeiteinheiten v = lu5.solve(R5 @ v) # hier wird WIRKLICH gelöst verlauf_cn.append(np.sum(v**2) / e0)fig, ax = plt.subplots(figsize=(6.6, 3.4))ax.semilogy(np.arange(1, len(verlauf_explizit)+1) *1.05, verlauf_explizit, label="explizit, S = 1,05")ax.semilogy(np.arange(1, 81) *5.0, verlauf_cn, label="implizit (CN), S = 5")ax.set_xlabel("Zeit (in Einheiten von Δx/c)")ax.set_ylabel("Energie / Anfangsenergie")ax.legend(); plt.tight_layout(); plt.show()print(f"explizit S=1,05: Energie ×{verlauf_explizit[-1]:.1e} (Abbruch)")print(f"CN S=5: Energie ×{verlauf_cn[-1]:.6f}")
Abbildung 7.2: Die Energie beider Verfahren (logarithmisch, über der physikalischen Zeit). Explizit mit S = 1,05 explodiert nach kurzem Anlauf um dreißig Größenordnungen — Crank–Nicolson läuft mit S = 5 unbeirrt energietreu weiter.
explizit S=1,05: Energie ×2.0e+30 (Abbruch)
CN S=5:          Energie ×1.000000
Das explizite Verfahren reißt schon bei 5 % Übermut die bekannte Instabilität auf (warum die Grenze exakt bei \(S = 1\) liegt, beweist Kapitel 8). Crank–Nicolson dagegen ist unbedingt stabil: Es gibt keinen zu großen Zeitschritt, die Energie bleibt auf sechs Nachkommastellen erhalten. Das wirkt wie Zauberei — fünffacher Zeitschritt, perfekte Energie. Zeit für die Ernüchterung:
WichtigVorhersage-Punkt
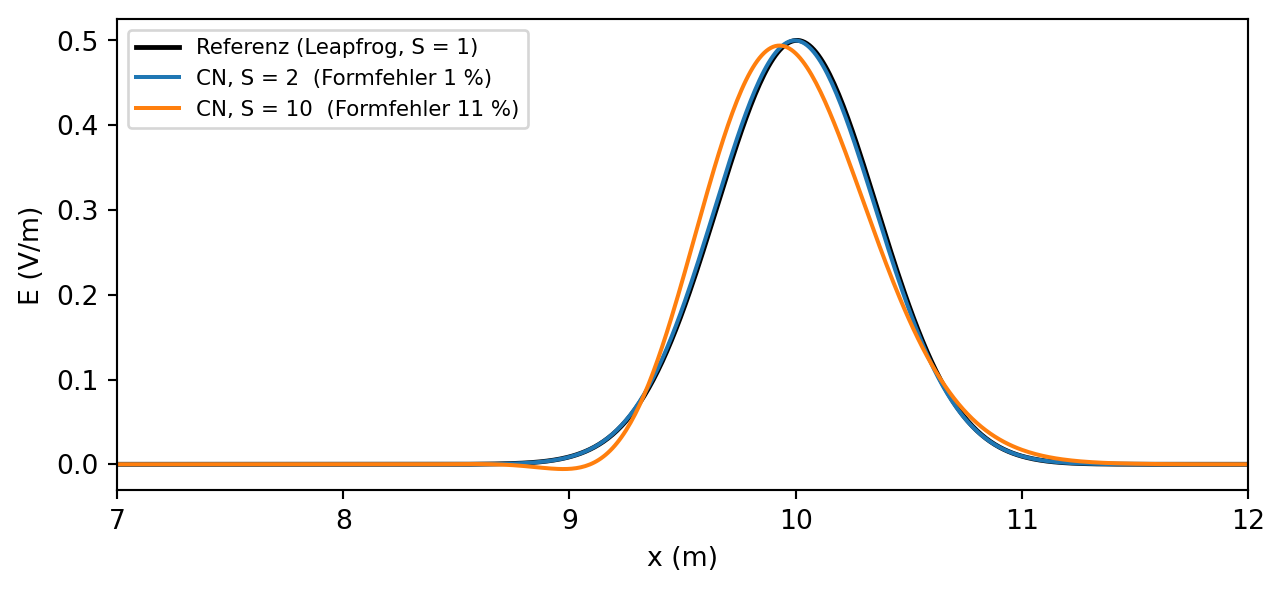
Bevor du die Zelle liest: Stabil und energieerhaltend — heißt das, das CN-Ergebnis bei \(S = 10\) ist auch richtig? Wir vergleichen die Pulsform nach derselben physikalischen Laufzeit mit der Leapfrog-Referenz. Lege dich fest.
Abbildung 7.3: Der rechte Puls nach gleicher physikalischer Laufzeit: Die Leapfrog-Referenz (schwarz) ist formtreu; Crank–Nicolson bleibt stabil und energietreu, aber mit wachsendem Zeitschritt eilt Welligkeit hinterher und die Form zerfasert — die Energie stimmt, ihre Verteilung nicht mehr.
Stabil heißt nicht genau. Die Energie ist exakt erhalten — aber sie sitzt zunehmend in nachlaufenden Kräuseln statt im Puls: 11 % Formfehler bei \(S = 10\), Tendenz steigend. Das ist kein Bug von CN, sondern das ehrliche Kleingedruckte jeder „unbedingten Stabilität”: Der große Zeitschritt tastet die Schwingung zu grob ab, und die Phasen der Wellenanteile geraten durcheinander. Wer die Welle auflösen will, braucht kleine Zeitschritte — dann aber kann man sie auch gleich explizit machen.
Das Standbild zeigt den Schaden nach 400 Schritten — in dieser HTML-Fassung siehst du ihn entstehen. Beide Läufe zeigen dieselbe physikalische Zeit: Die Leapfrog-Referenz (schwarz) macht pro Filmbild zehn kleine Schritte, Crank–Nicolson (orange) einen großen mit \(S = 10\). Anfangs liegen beide deckungsgleich übereinander. Dann beobachte per Einzelschritt, wie hinter den orangen Pulsen Kräusel ausfasern und immer länger werden — die Energie bleibt dabei die ganze Zeit exakt erhalten, sie wandert nur aus dem Puls in den Phasenmüll. Der Formfehler im Titel zählt mit.
In 1D ist der Faktor noch zahm, denn unser Gleichungssystem ist ein schmales Band — und die LU-Zerlegung von \(L\) fällt nur einmal an, danach wird pro Schritt nur eingesetzt. In 3D kippt die Rechnung: Dort hat das System Millionen Unbekannte, die Zerlegung füllt sich mit zusätzlichen Einträgen voll (fill-in), und man weicht auf iterative Löser aus, die pro Schritt selbst iterieren müssen. Explizite Verfahren skalieren dagegen einfach weiter: Nachbarn anschauen, addieren — notfalls auf tausend Prozessoren gleichzeitig.
Den Zweikampf kannst du in dieser HTML-Fassung selbst austragen — die folgende Zelle läuft editierbar im Browser (Run-Knopf oder Strg+Enter). Drei Durchgänge mit Ansage: S = 0.9 (beide brav?), S = 1.05 (wer kippt zuerst — und wie schnell?), S = 5 (der fünffache magische Schritt: Was macht Crank–Nicolson mit der Energie — und traust du deshalb auch der Form des Pulses?):
7.3 Wann welches Verfahren?
explizit (Leapfrog/FDTD)
implizit (z. B. Crank–Nicolson)
pro Schritt
Multiplikation — billig, speicherarm
Gleichungssystem lösen — teuer
Zeitschritt
begrenzt: \(S \le 1\) (CFL, Kap. 8)
beliebig groß: unbedingt stabil
großer Schritt
explodiert
stabil, aber Form zerfasert
parallelisierbar
hervorragend (nur Nachbarn)
schwieriger (globales System)
zu Hause bei
Wellen: Man will die Schwingung ohnehin zeitlich auflösen
Diffusion/Wärme, steife Probleme: Die Physik glättet, große Schritte schaden wenig (Ü 7.2)
typische Vertreter
FDTD, FIT (openEMS)
Wärmeleitung, SPICE, FEM-Zeitschritte, ADI-FDTD
Zwei Ergänzungen machen das Bild komplett. Erstens: Es gibt Mischformen — ADI-FDTD etwa rechnet implizit nur entlang jeweils einer Raumrichtung und umgeht so die CFL-Grenze, wenn winzige Geometriedetails (eine dünne Schicht, ein feiner Spalt) sonst absurd kleine Zeitschritte erzwingen würden. Zweitens: Stationäre Probleme — ein Potentialfeld, eine Antennen-Stromverteilung — haben gar keinen Zeitschritt; sie sind von Natur aus ein einziges großes Gleichungssystem. Die Momentenmethode (NEC), mit der wir ab Kapitel 11 Antennen rechnen, gehört in diese Welt: Dort ist „Matrix aufstellen und lösen” keine Wahl, sondern die Definition des Verfahrens.
Das Kapitel-Programmprogramme/kap07/kap07_explizit_implizit.py bündelt alle vier Befunde — Identität, CFL-Explosion, CN-Stabilität samt Formfehler, Kostenmessung — mit assert-Schranken.
TippMerkkasten
Die FDTD-Schleife ist ein Matrix-Vektor-Produkt \(v^{n+1} = A\,v^n\) mit dünnbesetztem \(A\) — eine Auswertung, kein Gleichungssystem. Explizit = Unbekannte nur links.
Implizit = Unbekannte auf beiden Seiten (\(L\,v^{n+1} = R\,v^n\)): jeder Schritt löst ein System — dafür unbedingt stabil.
Stabil ≠ genau: Zu große implizite Schritte tasten die Schwingung zu grob ab; die Energie stimmt, die Form nicht.
Faustregel: Wellen explizit (Zeitauflösung braucht man ohnehin), Diffusion und steife Probleme implizit, stationäre Probleme sind immer ein großes System.
Roter Faden
Die zwei Bänder in der spy-Abbildung sind exakt die np.diff-Zeilen aus Kapitel 5/6 — nichts an diesem Kapitel war neue Physik, nur ein neuer Blick. Die Matrix-Sicht trägt ab jetzt: Kapitel 8 liest aus den Eigenwerten von \(A\) ab, warum die CFL-Grenze exakt bei \(S = 1\) liegt (Übung 7.4 nimmt den Vorgeschmack). Kapitel 11 sortiert die Löser-Landschaft — und du wirst die Trennlinie dieses Kapitels dort überall wiedererkennen: Meep und openEMS marschieren explizit, NEC stellt auf und löst.
Übungen
Ü 7.1 (Verstehen). Wenn der explizite Schritt die Matrix \(A\) nie braucht — wozu ist es dann trotzdem nützlich, sie aufstellen zu können? Nenne mindestens zwei Gründe.
HinweisMusterlösung zu Ü 7.1
Erstens als Analysewerkzeug: Eigenschaften des Verfahrens — Stabilität, Erhaltungsgrößen, Fehlerverhalten — sind Eigenschaften der Matrix (ihre Eigenwerte entscheiden über Explodieren oder Erhalten, siehe Ü 7.4 und Kapitel 8). Zweitens als Verständigungsmittel: Erst in Matrixform kann man explizite und implizite Verfahren nebeneinanderlegen und sieht, dass sie sich nur darin unterscheiden, auf welcher Seite die Unbekannte steht. Drittens (Bonus) als Korrektheitsbeweis: Die Übereinstimmung von Schleife und \(A\cdot v\) auf \(10^{-15}\) belegt, dass der Code genau das lineare Verfahren implementiert, das er behauptet.
Ü 7.2 (Verstehen). Für die Wärmeleitungsgleichung (Diffusion) verlangt das explizite Verfahren \(\Delta t \le \Delta x^2/(2D)\) — beachte das Quadrat. Warum macht das implizite Verfahren dort so viel attraktiver als bei Wellen?
HinweisMusterlösung zu Ü 7.2
Zweimal Quadrat-Pech für explizit: Halbiert man bei Diffusion den Gitterabstand, muss der Zeitschritt auf ein Viertel schrumpfen (bei Wellen nur auf die Hälfte) — feine Gitter werden explizit ruinös teuer. Gleichzeitig ist der große implizite Schritt bei Diffusion fast gratis: Die Physik glättet alles Schnelle von selbst weg, es gibt keine Schwingungsphasen, die ein grober Schritt verfehlen könnte (genau daran scheiterte CN bei unserer Welle). Implizit passt also zur Diffusion wie explizit zur Welle: Das Verfahren sollte der Physik ähneln, die es rechnet.
Ü 7.3 (Verändern). Ersetze Crank–Nicolson durch Rückwärts-Euler: \((I - M)\,v^{n+1} = v^{n}\) (die Änderungsrate wird nur am neuen Zeitpunkt ausgewertet). Lass den Puls mit \(S = 2\) über dieselbe Strecke laufen wie in der Genauigkeits-Abbildung. Was passiert mit Amplitude und Energie — und ist das je nützlich?
HinweisMusterlösung zu Ü 7.3
# von oben: differenzmatrix(), sp, N, splu, startzustand(), e0def matrix_m(s, n=N): d = differenzmatrix(n) g = sp.vstack([sp.csr_matrix((1, n -1)), differenzmatrix(n -1), sp.csr_matrix((1, n -1))], format="csr")return sp.bmat([[sp.csr_matrix((n, n)), -s * g], [-s * d, sp.csr_matrix((n -1, n -1))]], format="csr")L_be = (sp.identity(2*N -1, format="csr") - matrix_m(2.0)).tocsc()lu_be = splu(L_be)v = startzustand()for _ inrange(200): # 200 Schritte à S = 2 v = lu_be.solve(v)print(f"Energie: {np.sum(v**2)/e0:.3f} Amplitude: {np.max(v[:N]):.3f}"f" (Referenz-Amplitude: 0.5)")
Der Puls schrumpft: gut ein Fünftel der Energie ist verschwunden, die Spitze auf 0,39 gefallen — Rückwärts-Euler ist stabil, aber numerisch dissipativ: Es vernichtet Energie, die physikalisch erhalten wäre, am stärksten die feinen Anteile. Für Wellen ist das Gift. Nützlich ist es trotzdem — genau dann, wenn man Dämpfung möchte: um störende Transienten wegzubeißen, steife Anteile ruhigzustellen oder ein stationäres Gleichgewicht schnell zu erreichen. Auch Dissipation ist ein Werkzeug; man muss nur wissen, dass man es in der Hand hält.
Ü 7.4 (Übertragen). Die Stabilität eines linearen Verfahrens steckt in den Eigenwerten seiner Schritt-Matrix: Bei jedem Schritt wird jeder Eigenanteil mit seinem \(\lambda\) multipliziert — gibt es ein \(|\lambda| > 1\), wächst er exponentiell. Berechne \(\max|\lambda|\) von \(A\) (kleines Gitter, \(n = 80\)) für \(S = 0{,}5,\ 1{,}0,\ 1{,}05\) und deute das Ergebnis.
HinweisMusterlösung zu Ü 7.4
# von oben: matrizen()for s in (0.5, 1.0, 1.05): A80, _, _ = matrizen(s, n=80)# np.linalg.eigvals: alle Eigenwerte einer (vollen) Matrix lam = np.linalg.eigvals(A80.toarray())print(f"S = {s:4}: max|λ| = {np.max(np.abs(lam)):.6f}")
S =  0.5:  max|λ| = 1.000000
S =  1.0:  max|λ| = 1.000000
S = 1.05:  max|λ| = 1.874893
Bei \(S \le 1\) liegen alle Eigenwerte auf dem Einheitskreis (\(|\lambda| = 1\)): Kein Anteil wächst, keiner stirbt — das Verfahren erhält, was es transportiert. Bei \(S = 1{,}05\) springt \(\max|\lambda|\) auf 1,87: Der zugehörige Eigenanteil wird pro Schritt fast verdoppelt, und weil Rundungsrauschen jeden Eigenanteil mikroskopisch enthält, explodiert jede Simulation — exakt der Mechanismus aus Kapitel 5 (Ü 5.2). Die Stabilitätsfrage ist damit auf eine Eigenwertfrage geschrumpft, und Kapitel 8 beantwortet sie analytisch: Warum kippt \(|\lambda|\) genau bei \(S = 1\)?
Das Kleingedruckte
Zeitmessungen wie unsere µs-Werte hängen von Rechner, NumPy- Version und Tagesform ab — belastbar ist die Größenordnung und der Trend (1D-Band: einstelliger Faktor; 3D: Welten), nicht die Ziffer.
CN ist nicht „das” implizite Verfahren, sondern der symmetrische Vertreter einer Familie (\(\theta\)-Verfahren): Rückwärts-Euler (Ü 7.3) ist ihr dissipatives Ende, CN das erhaltende. Profi-Löser mischen je nach Bedarf.
Die LU-Zerlegung vorab funktioniert nur, weil unsere Matrix \(L\) konstant ist (lineares Material, festes Gitter). Sobald sich Materialeigenschaften mit der Zeit oder dem Feld ändern (nichtlineare Optik, Teil VII-Ausblick), muss implizit pro Schritt neu zerlegt oder iteriert werden — der Kostenvorteil von explizit wächst dann weiter.
„Unbedingt stabil” gilt pro Verfahren, nicht pro Problem: Auch CN kann durch Randbedingungen, variable Koeffizienten oder Kopplungen seine Garantie verlieren. Stabilität prüft man am Gesamtsystem — im Zweifel so, wie wir hier: messen.