Code
laenge_m = 1.0
hoehe_m = 0.1
temperatur_links_grad = 20.0
temperatur_rechts_grad = 300.0In Kapitel 1 hast du an einer Blackbox gedreht: drei Regler für die Brandgase, das Netz und die Zeit, und darunter ein „Maschinenraum”, den du noch nicht verstehen musstest (er kürzt mit dem Rechenpaket NumPy ab, damit dein Browser flott rechnet). Das Buch baut genau diese Maschine nun in reinem Python nach — ein Programm von ein paar hundert Zeilen, das im großen Finale (Kapitel 15) komplett vor dir liegt. Und jetzt kommt das Versprechen, das dir die Angst nehmen soll: Jede einzelne dieser Zeilen benutzt nur, was du in diesem Kapitel lernst. Nicht mehr. Keine geheime Zutat, kein höheres Programmierstudium — Variablen, Listen, Schleifen, ein paar Funktionen. Das ist alles.
Dieses Kapitel ist deshalb kein Programmierkurs, sondern ein Werkzeugkasten. Wir bringen genau so viel Python bei, wie das Buch braucht — und keine Fingerübung ist umsonst: Jedes Beispiel rechnet schon etwas am Träger aus. Wir zählen keine erfundenen Zahlen zusammen, sondern die Temperaturen an den fünf Knoten unseres Stahlträgers. So lernst du das Werkzeug immer an dem Ding kennen, für das du es später brauchst.
Nach diesem Kapitel kannst du …
print formatiert ausgeben — eine saubere Temperaturtabelle drucken,for-Schleifen Summen bilden und alle Knoten ablaufen,if Fälle unterscheiden — etwa Randknoten von inneren Knoten,Vermutung: „Um Simulationen zu programmieren, muss man ein Mathe- oder Informatik-Profi sein.”
Warum sie naheliegt: Das fertige Programm aus Kapitel 1 sieht kompliziert aus, und „Finite-Elemente-Methode” klingt nach einem Ingenieurstudium. Wer noch nie programmiert hat, vermutet dahinter Zauberei.
Was stattdessen stimmt: Der Kern unseres FEM-Programms besteht aus Listen, Schleifen und Additionen — genau den Werkzeugen dieses Kapitels. Die Klugheit der Methode steckt nicht im Code, sondern in der Idee, den Träger in Stücke zu zerlegen. Ist die Idee erst da, ist der Code erstaunlich schlicht. Das ganze Buch ist der Beweis: Am Ende liest du jede Zeile des Finales — und wunderst dich, wie wenig dahintersteckt.
Ein Programm rechnet mit Werten — mit der Länge des Trägers, mit einer Temperatur, mit einer Anzahl von Knoten. Damit man diese Werte nicht jedes Mal neu hinschreiben muss und damit man sie später wiedererkennt, gibt man ihnen einen Namen. Ein solcher benannter Wert heißt Variable.
Stell dir ein beschriftetes Marmeladenglas vor: Außen klebt ein Schild („Erdbeere”), innen ist der Inhalt. Die Variable ist das Schild, der Wert ist der Inhalt. Und so schreibt man das in Python auf:
laenge_m = 1.0
hoehe_m = 0.1
temperatur_links_grad = 20.0
temperatur_rechts_grad = 300.0Das Gleichheitszeichen ist hier kein „ist gleich” wie in der Mathematik. Es bedeutet: „Nimm den Wert rechts und häng ihm das Schild links an.” Ab jetzt steht der Name laenge_m überall für die Zahl 1.0. Wir haben damit die Daten unseres Trägers benannt — links kühl bei 20 °C im Auflager, ein Meter lang, eine Handbreit (0,1 m) hoch. Das rechte Ende, das der Brandherd aufheizt, setzen wir auf 300 °C: die Temperatur in der Frühphase des Feuers und zugleich der Standardwert des Handbeispiels, mit dem das Buch alle Rechnungen vorführt (in der Blackbox aus Kapitel 1 durftest du die Brandgase ja beliebig heiß drehen).
Zwei Sorten von Werten begegnen uns dabei: Zahlen wie 1.0 oder 20.0, mit denen man rechnet, und Text wie "Knoten", der immer in Anführungszeichen steht und einfach das ist, was dort geschrieben steht. Die Regel, deutsche sprechende Namen zu verwenden (laenge_m statt L), ist Absicht: Der Code soll sich lesen wie eine Beschreibung dessen, was er tut. Nur eine Kleinigkeit: In Python-Namen dürfen keine Umlaute stehen, darum schreiben wir laenge statt „länge” und waermster statt „wärmster”.
Mit Variablen rechnet man wie mit den Zahlen selbst. Unser Träger hat fünf Knoten (das Standard-Beispiel des Buches); der Abstand zwischen zwei benachbarten Knoten ergibt sich aus Länge und Knotenzahl:
knotenzahl = 5
abstand_m = laenge_m / (knotenzahl - 1)
print(abstand_m)0.25Warum knotenzahl - 1? Fünf Knoten spannen vier gleich lange Abschnitte auf — wie fünf Zaunpfähle vier Zaunfelder ergeben. Ein Meter auf vier Felder verteilt macht 0,25 m pro Feld. Genau diese 0,25 m — der Knotenabstand \(h\) des Handbeispiels — wird uns durch das ganze Buch begleiten.
Das Wörtchen print in der letzten Zeile ist der Befehl, mit dem ein Programm etwas „laut ausspricht”, also auf den Bildschirm schreibt. Ohne print rechnet das Programm zwar, sagt aber nichts. Und weil sauberes Ausdrucken in diesem Buch ein wichtiges Werkzeug ist — wir werden ganze Gleichungssysteme als Text drucken —, schauen wir uns print genauer an.
Ein nacktes print(abstand_m) schreibt bloß 0.25 hin, ohne zu sagen, was das ist. Schöner wäre ein ganzer Satz mit der Zahl mittendrin. Dafür gibt es den f-String — man kann ihn sich als Lückentext vorstellen: ein Satz mit Lücken, in die Werte eingesetzt werden.
Man setzt ein kleines f direkt vor das Anführungszeichen. Das f signalisiert: In diesem Text stecken Lücken in geschweiften Klammern {…}, und in jede Lücke kommt der Wert, der drinsteht.
knoten_nummer = 3
temperatur_grad = 160.0
print(f"Knoten {knoten_nummer} ist {temperatur_grad} Grad warm.")
Knoten 3 ist 160.0 Grad warm.Python ersetzt {knoten_nummer} durch 3 und {temperatur_grad} durch 160.0 und druckt den fertigen Satz. Der Lückentext bleibt lesbar, und die Zahlen stehen an ihrem Platz.
Für Tabellen brauchen wir noch eine Kleinigkeit: Zahlen sollen sauber untereinander stehen. Dafür schreibt man hinter die Variable in der Lücke einen Doppelpunkt und ein Format. {temperatur_grad:6.1f} heißt: „sechs Zeichen breit, eine Nachkommastelle”. Die feste Breite sorgt dafür, dass alle Zahlen rechtsbündig in einer Spalte landen — auch wenn die eine dreistellig und die andere zweistellig ist.
print(f"{20.0:6.1f}")
print(f"{160.0:6.1f}")
print(f"{300.0:6.1f}")
20.0
160.0
300.0Die drei Zahlen stehen ordentlich untereinander, weil jede genau sechs Zeichen breit gedruckt wird. Mehr Formatierung brauchen wir im ganzen Buch nicht — dieses eine Muster :6.1f reicht für alle unsere Tabellen.
Jetzt kommt das wichtigste Werkzeug des Kapitels. Bisher hatte jede Variable einen Wert. Aber unser Träger hat fünf Knoten, und jeder hat seine eigene Temperatur. Fünf einzelne Variablen anzulegen (temperatur0, temperatur1, …) wäre unhandlich — und bei einem feinen Netz mit hundert Knoten unmöglich.
Die Lösung ist die Liste: eine geordnete Reihe von Werten unter einem einzigen Namen. Das Bild dazu ist ein Eierkarton mit nummerierten Mulden — ein Behälter, viele Fächer, jedes Fach hält einen Wert. Man schreibt die Werte in eckigen Klammern, durch Kommas getrennt:
temperaturen = [20.0, 20.0, 20.0, 20.0, 300.0]
print(temperaturen)
[20.0, 20.0, 20.0, 20.0, 300.0]Diese fünf Zahlen sind der Anfangszustand unseres Trägers, genau der Moment, in dem Kapitel 1 die Simulation startet: Der Brandherd hat das rechte Ende schon auf 300 °C gebracht — die Frühphase des Feuers —, der ganze Rest liegt noch kühl bei 20 °C, festgehalten vom Auflager. Ein Wert pro Knoten, fünf Knoten, fünf Zahlen in einer Liste. Genau das meint der Fachbegriff diskretisieren: die durchgehende Temperatur des echten Trägers durch endlich viele Zahlen an endlich vielen Knoten ersetzen. Die Liste ist der diskretisierte Träger.
Abbildung 2.1 macht das sichtbar — es ist die wichtigste Grafik dieses Kapitels, präg sie dir ein:
import matplotlib.pyplot as plt

temperaturen = [20.0, 20.0, 20.0, 20.0, 300.0]
orte = [0.0, 0.25, 0.5, 0.75, 1.0]
norm = plt.Normalize(20.0, 300.0)
farbkarte = plt.get_cmap("inferno")

fig, ax = plt.subplots(figsize=(8.5, 4.2))

# Der physische Traeger als graues Band
ax.add_patch(plt.Rectangle((0.0, -0.04), 1.0, 0.08, facecolor="0.85",
                           edgecolor="black", lw=1.3, zorder=1))
# Auflager links (kuehl gehalten)
ax.add_patch(plt.Rectangle((-0.06, -0.09), 0.06, 0.18, hatch="///",
                           facecolor="lightsteelblue", edgecolor="black",
                           zorder=2))
ax.text(-0.03, -0.12, "Auflager\n20 °C", ha="center", va="top", fontsize=8)
# Brandherd rechts
ax.fill([1.0, 1.09, 1.0], [-0.04, 0.0, 0.04], color="orangered", zorder=2)
ax.text(1.11, 0.0, "Brandherd", va="center", color="orangered", fontsize=9)

kasten_y, kasten_h, kasten_b = 0.16, 0.07, 0.14
for i in range(5):
    x = orte[i]
    farbe = farbkarte(norm(temperaturen[i]))
    # Knotenpunkt auf dem Traeger, eingefaerbt nach Temperatur
    ax.plot(x, 0.0, "o", ms=14, color=farbe, markeredgecolor="black",
            markeredgewidth=1.0, zorder=4)
    # Kaestchen mit dem Listenwert darueber
    ax.add_patch(plt.Rectangle((x - kasten_b / 2, kasten_y), kasten_b, kasten_h,
                               facecolor="white", edgecolor="black", lw=1.3,
                               zorder=3))
    ax.text(x, kasten_y + kasten_h / 2, "%.1f" % temperaturen[i], ha="center",
            va="center", fontsize=11, zorder=4)
    # Index ueber dem Kaestchen
    ax.text(x, kasten_y + kasten_h + 0.015, "[%d]" % i, ha="center",
            va="bottom", fontsize=11, color="tab:blue", weight="bold")
    # Pfeil vom Kaestchen hinunter zum Knoten
    ax.annotate("", xy=(x, 0.035), xytext=(x, kasten_y - 0.005),
                arrowprops=dict(arrowstyle="->", color="0.4", lw=1.0),
                zorder=2)

ax.text(-0.12, kasten_y + kasten_h / 2, "temperaturen =", ha="right",
        va="center", fontsize=11, style="italic")
ax.set_xlim(-0.42, 1.32)
ax.set_ylim(-0.20, 0.33)
ax.set_yticks([])
ax.set_xlabel("Ort entlang des Trägers (0 = Auflager, 1 m = Brandherd)")
ax.set_title("Die Liste über dem Träger: fünf Zahlen für fünf Knoten")
plt.tight_layout()
plt.show()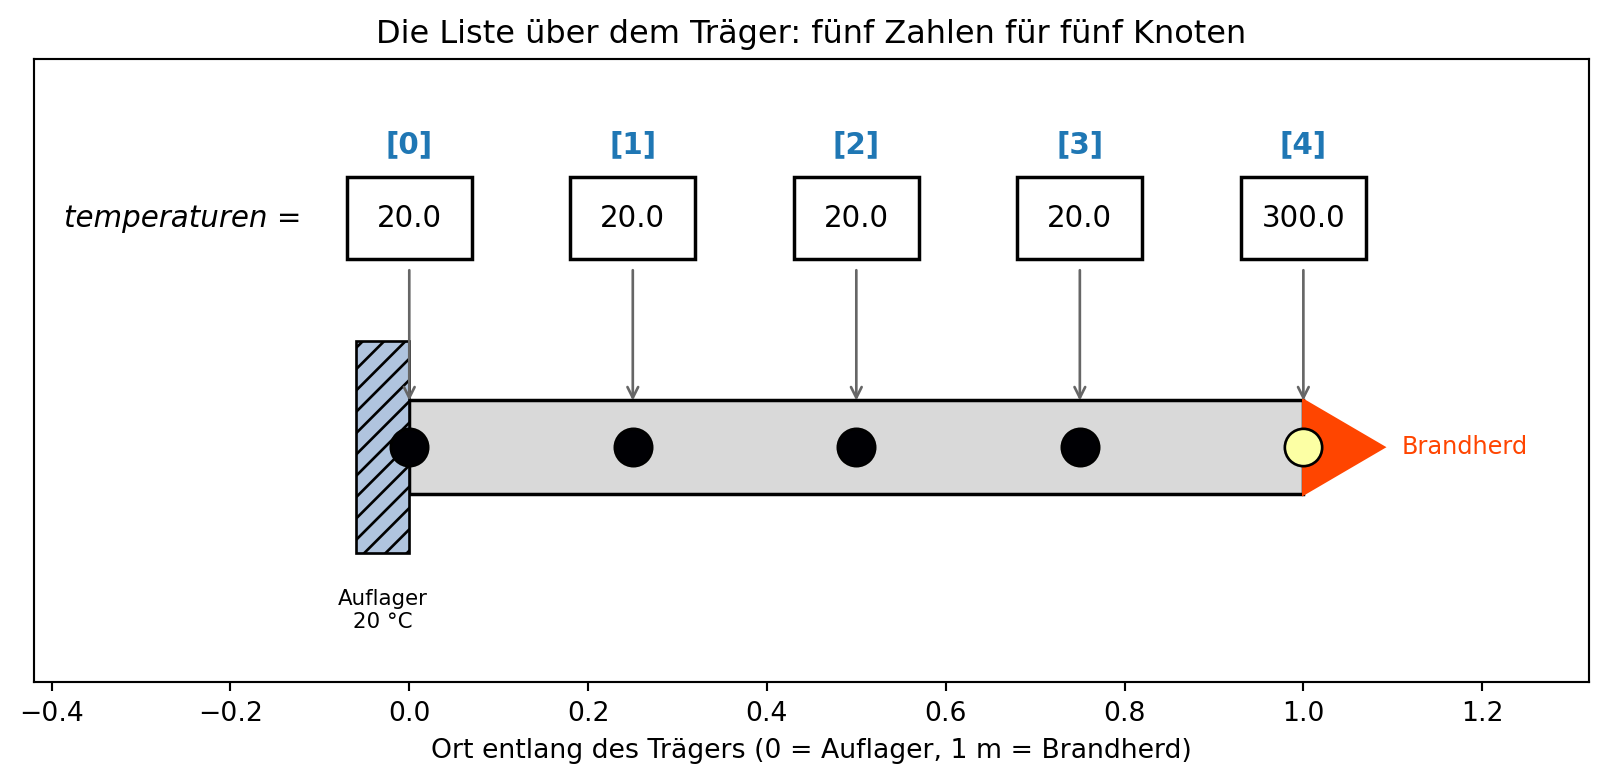
Was man hier sieht: Die Liste und der Träger sind dasselbe, nur zwei Mal gezeichnet. Jedes Kästchen sitzt über genau einem Knoten; sein Inhalt ist dessen Temperatur. Die blaue Zahl in eckigen Klammern darüber ist der Index — die Nummer des Fachs. Und hier die eine Überraschung, die jeden Anfänger stolpern lässt: Python zählt ab null. Der erste Eintrag ist [0], nicht [1].
Das ist weniger seltsam, als es klingt. In einem deutschen Haus wohnt man im Erdgeschoss, dann kommt der erste Stock, der zweite und so weiter — das Erdgeschoss ist nicht „der erste Stock”, sondern die Nummer null der Etagen. Genauso ist es bei der Liste: Der linke Knoten im Auflager ist Fach [0], der Knoten am Brandherd ist Fach [4]. Fünf Fächer, nummeriert von 0 bis 4.
Einen einzelnen Wert holt man mit seinem Index in eckigen Klammern heraus:
print(temperaturen[0])
print(temperaturen[4])
20.0
300.0temperaturen[0] ist die 20,0 am kühlen Auflager, temperaturen[4] die 300,0 am Brandherd. Wie viele Fächer die Liste hat, verrät len (von englisch length, Länge):
print(len(temperaturen))5Fünf Fächer — und weil sie ab 0 nummeriert sind, ist das letzte Fach temperaturen[4], also temperaturen[len(temperaturen) - 1]. Diese Zeile werden wir noch oft brauchen: „der letzte Knoten”.
Eine Liste ist nicht in Stein gemeißelt — man kann einen Eintrag überschreiben, so wie man ein Ei aus einer Mulde nimmt und ein anderes hineinlegt. Sagen wir, der Brand frisst weiter und das rechte Ende steigt auf 350 °C:
temperaturen[4] = 350.0
print(temperaturen)
temperaturen[4] = 300.0   # wieder zurueck auf den Buchwert
[20.0, 20.0, 20.0, 20.0, 350.0]Später, wenn die Wärme durch den Träger wandert, tut unser Programm genau das in jedem Zeitschritt: Es überschreibt die Temperaturen an den inneren Knoten mit ihren neuen Werten. Eine Liste, die sich Schritt für Schritt ändert — mehr passiert bei der ganzen Wärmesimulation nicht.
Wir haben fünf Temperaturen und wollen etwas mit jeder tun — sie drucken, aufsummieren, vergleichen. Das von Hand fünfmal (oder bei feinem Netz hundertmal) hinzuschreiben, wäre mühsam und fehleranfällig. Dafür gibt es die Schleife: eine Anweisung „tu das Folgende mit jedem Eintrag der Reihe nach”. Das Bild dazu: Du gehst ein Wohnhaus ab und leerst der Reihe nach jeden Briefkasten — dieselbe Handlung, ein Fach nach dem anderen.
In Python heißt diese Schleife for. Die einfachste Form nimmt sich direkt jeden Wert der Liste vor:
for temperatur in temperaturen:
    print(f"{temperatur:6.1f} °C")
20.0 °C
20.0 °C
20.0 °C
20.0 °C
300.0 °CMan liest das fast wie einen deutschen Satz: „Für jede temperatur in temperaturen: drucke sie.” Der Name temperatur (ohne s) ist eine Variable, die die Schleife bei jedem Durchgang mit dem nächsten Wert füllt: erst 20,0, dann wieder 20,0, … und zuletzt 300,0. Wichtig ist die Einrückung: Alles, was eingerückt unter dem for steht, gehört zur Schleife und wird bei jedem Durchgang wiederholt. Die Einrückung ist keine Verzierung, sondern sagt Python, was wiederholt werden soll.
Abbildung 2.2 zeigt, wie die Schleife über den Träger läuft:
import matplotlib.pyplot as plt

orte = [0.0, 0.25, 0.5, 0.75, 1.0]
temperaturen = [20.0, 20.0, 20.0, 20.0, 300.0]
norm = plt.Normalize(20.0, 300.0)
farbkarte = plt.get_cmap("inferno")

fig, ax = plt.subplots(figsize=(8.5, 3.0))
ax.add_patch(plt.Rectangle((0.0, -0.04), 1.0, 0.08, facecolor="0.85",
                           edgecolor="black", lw=1.3, zorder=1))
for i in range(5):
    farbe = farbkarte(norm(temperaturen[i]))
    ax.plot(orte[i], 0.0, "o", ms=15, color=farbe, markeredgecolor="black",
            markeredgewidth=1.0, zorder=3)
    ax.text(orte[i], -0.11, "[%d]" % i, ha="center", va="top", fontsize=11,
            color="tab:blue", weight="bold")
for i in range(4):
    ax.annotate("", xy=(orte[i + 1], 0.05), xytext=(orte[i], 0.05),
                arrowprops=dict(arrowstyle="->", color="tab:green", lw=1.8,
                                connectionstyle="arc3,rad=-0.55"))
ax.text(0.5, 0.20, "die Schleife läuft von [0] nach [4]", ha="center",
        fontsize=11, color="tab:green")
ax.set_xlim(-0.1, 1.1)
ax.set_ylim(-0.19, 0.27)
ax.set_yticks([])
ax.set_xlabel("Ort entlang des Trägers (m)")
plt.tight_layout()
plt.show()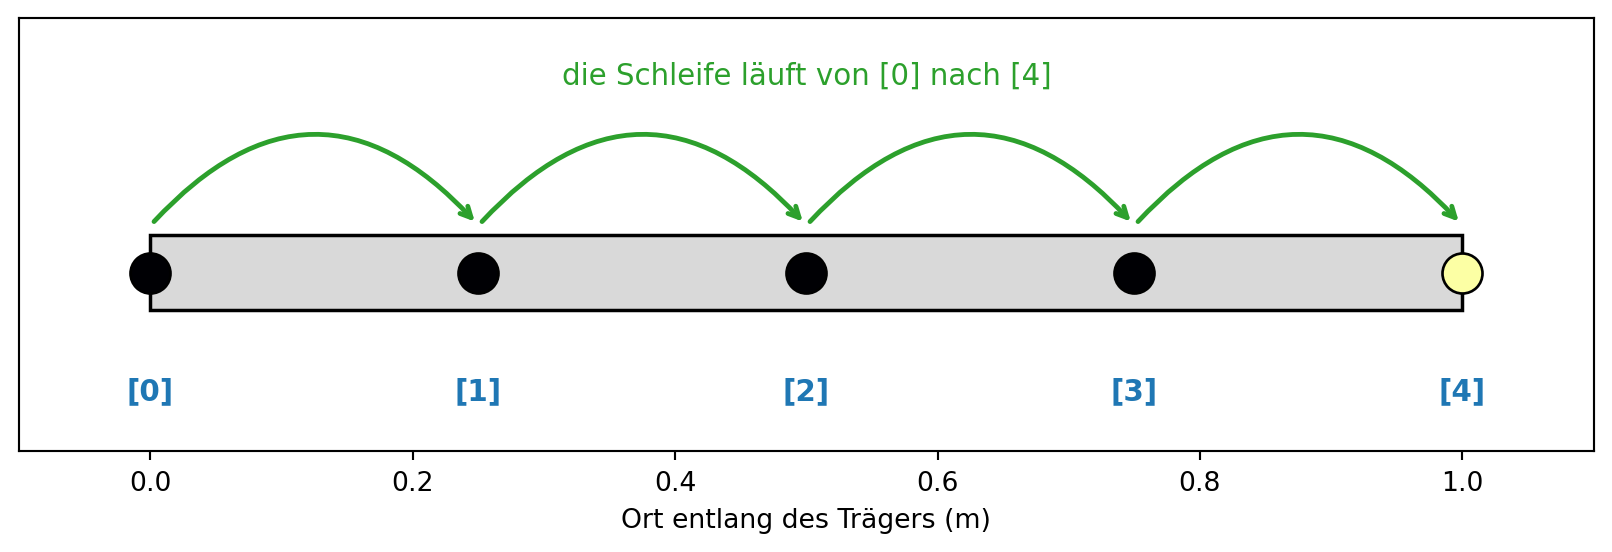
Was man hier sieht: Die Schleife ist kein Sprung ins Ungewisse, sondern ein geordneter Gang von Knoten zu Knoten. Jeder grüne Bogen ist ein Schleifendurchgang. Am Ende, bei [4], ist die Schleife fertig — sie hat jeden Knoten genau einmal besucht.
Der häufigste Grund für eine Schleife in diesem Buch ist das Aufsummieren. Um den Mittelwert der fünf Temperaturen zu bekommen, müssen wir sie erst alle zusammenzählen. Der Trick heißt laufende Summe: ein Zähler, der bei null beginnt und bei jedem Knoten um dessen Temperatur wächst.
Bevor wir das laufen lassen, eine Vorhersage:
summe = 0.0
for temperatur in temperaturen:
    summe = summe + temperatur

mittelwert = summe / len(temperaturen)
print(f"Summe:      {summe:6.1f}")
print(f"Mittelwert: {mittelwert:6.1f}")
Summe: 380.0
Mittelwert: 76.0Die Zeile summe = summe + temperatur sieht mathematisch unmöglich aus — eine Zahl kann nicht sich selbst plus etwas sein. Aber das Gleichheitszeichen ist ja der „Nimm-rechts, häng-links-an”-Befehl von vorhin: Nimm den alten Wert von summe, addiere die aktuelle Temperatur, und mach das Ergebnis zum neuen summe. Der Zähler klettert so von 0 über 20, 40, 60, 80 auf 380 — und 380 geteilt durch 5 ergibt einen Mittelwert von 76,0 °C. Lag deine Vorhersage daneben? Der große Sprung am Schluss ist die 300 am Brandherd, die den Schnitt hochzieht, obwohl vier von fünf Knoten noch kalt sind.
Diese laufende Summe ist übrigens ein alter Bekannter aus der Mathematik: Das große Summenzeichen \(\Sigma\), dem wir in späteren Kapiteln oft begegnen, ist nichts anderes als genau diese Schleife, nur auf Papier geschrieben. „\(\sum_i T_i\)” heißt wörtlich: „lauf mit \(i\) über alle Knoten und zähl die \(T_i\) zusammen” — Zeile für Zeile dasselbe wie unsere for-Schleife.
Die folgende Darstellung zeigt die laufende Summe beim Hochzählen — in der HTML-Fassung als Animation, im Druck als Bildreihe:
import matplotlib.pyplot as plt
from matplotlib.animation import FuncAnimation
from IPython.display import HTML

temperaturen = [20.0, 20.0, 20.0, 20.0, 300.0]
orte = [0.0, 0.25, 0.5, 0.75, 1.0]
norm = plt.Normalize(20.0, 300.0)
farbkarte = plt.get_cmap("inferno")

summen = []
laufend = 0.0
for wert in temperaturen:
    laufend = laufend + wert
    summen.append(laufend)

fig, ax = plt.subplots(figsize=(8.5, 3.4))
ax.add_patch(plt.Rectangle((0.0, -0.04), 1.0, 0.08, facecolor="0.85",
                           edgecolor="black", lw=1.3, zorder=1))
for i in range(5):
    farbe = farbkarte(norm(temperaturen[i]))
    ax.plot(orte[i], 0.0, "o", ms=15, color=farbe, markeredgecolor="black",
            markeredgewidth=1.0, zorder=3)
    ax.text(orte[i], -0.115, "[%d]" % i, ha="center", va="top", fontsize=10,
            color="tab:blue", weight="bold")
ring = ax.scatter([], [], s=560, facecolors="none", edgecolors="tab:green",
                  linewidths=3, zorder=5)
kopf = ax.text(0.5, 0.205, "", ha="center", fontsize=12)
summentext = ax.text(0.5, 0.13, "", ha="center", fontsize=12,
                     color="tab:green", weight="bold")
ax.set_xlim(-0.1, 1.12)
ax.set_ylim(-0.19, 0.28)
ax.set_yticks([])
ax.set_xlabel("Ort entlang des Trägers (m)")

def zeichne(k):
    ring.set_offsets([[orte[k], 0.0]])
    kopf.set_text("Knoten [%d]:  Temperatur %.0f °C" % (k, temperaturen[k]))
    summentext.set_text("Summe bisher: %.0f" % summen[k])
    return ring, kopf, summentext

ani = FuncAnimation(fig, zeichne, frames=5, interval=1000, blit=False)
plt.close(fig)
HTML(ani.to_jshtml())Was man hier sieht: Die Summe wächst in gleichmäßigen Schritten von 20 durch die vier kalten Knoten — und schnellt beim letzten, dem Knoten am Brandherd, von 80 auf 380 hoch. Eine einzige heiße Zahl unter vier kalten prägt das Ergebnis. Genau dieses Gefühl, wie eine Summe sich aus ihren Beiträgen aufbaut, brauchst du, wenn wir später ganze Gleichungssysteme aufaddieren.
Manchmal genügt der Wert allein nicht — wir brauchen auch die Nummer des Knotens, etwa um seinen Ort auf dem Träger auszurechnen (Ort = Index mal Abstand). Dann läuft die Schleife nicht über die Werte, sondern über die Indizes 0, 1, 2, 3, 4. Die liefert range(5): „die Zahlen von 0 bis unter 5”. Allgemein schreibt man range(len(temperaturen)), damit es auch bei mehr Knoten stimmt.
Und damit drucken wir endlich die vollständige Temperaturtabelle — die Zusammenführung von Liste, Schleife und f-String:
print("Knoten | Ort (m) | Temperatur")
print("-------+---------+-----------")
for index in range(len(temperaturen)):
    ort_m = index * abstand_m
    print(f"  [{index}]  |  {ort_m:4.2f}   | {temperaturen[index]:6.1f} °C")
Knoten | Ort (m) | Temperatur
-------+---------+-----------
[0] | 0.00 | 20.0 °C
[1] | 0.25 | 20.0 °C
[2] | 0.50 | 20.0 °C
[3] | 0.75 | 20.0 °C
[4] | 1.00 | 300.0 °CInnerhalb der Schleife holt temperaturen[index] den Wert am aktuellen Knoten, und index * abstand_m rechnet dessen Ort aus: Knoten [0] sitzt bei 0,00 m, Knoten [2] bei 0,50 m, Knoten [4] bei 1,00 m — am Brandherd-Ende. So eine Tabelle ist in diesem Buch kein Nebenprodukt, sondern ein Hauptwerkzeug: Wir werden Temperaturen, Kräfte und ganze Matrizen als solche Textblöcke drucken und ihnen ansehen, ob die Rechnung stimmt.
ifBisher tat die Schleife mit jedem Knoten dasselbe. Oft aber müssen wir Fälle unterscheiden: Ein Knoten am Rand des Trägers wird anders behandelt als einer in der Mitte. Der linke Randknoten steckt im Auflager (seine Temperatur ist fest vorgegeben), der rechte am Brandherd — nur die inneren Knoten rechnet die Simulation überhaupt aus. Diese Unterscheidung trifft das Schlüsselwort if (englisch für „falls”).
Das Bild dazu ist eine Weggabelung: Trifft eine Bedingung zu, geht es den einen Weg (if), sonst den anderen (else, „sonst”). Ein Knoten ist ein Randknoten, wenn sein Index der erste (0) oder der letzte (len(temperaturen) - 1) ist:
for index in range(len(temperaturen)):
    if index == 0 or index == len(temperaturen) - 1:
        rolle = "Randknoten"
    else:
        rolle = "innerer Knoten"
    print(f"[{index}] {temperaturen[index]:6.1f} °C  ({rolle})")
[0] 20.0 °C (Randknoten)
[1] 20.0 °C (innerer Knoten)
[2] 20.0 °C (innerer Knoten)
[3] 20.0 °C (innerer Knoten)
[4] 300.0 °C (Randknoten)Zwei Dinge sind hier neu. Erstens das doppelte Gleichheitszeichen ==: Es fragt „sind die beiden gleich?“, während das einfache = etwas zuweist. Der Unterschied ist wichtig — = befiehlt, == fragt. Zweitens das or („oder”): Die Bedingung ist erfüllt, wenn entweder der Index 0 oder der letzte ist. So bekommen genau die beiden Enden das Schild „Randknoten”, die drei mittleren das Schild „innerer Knoten”.
Diese Sortierung nach Rand und Innerem ist kein Selbstzweck. Sie ist das Herz der Randbedingungen, denen Kapitel 8 ein ganzes Kapitel widmet: An den Randknoten wissen wir die Temperatur schon (Auflager und Brandherd), an den inneren müssen wir sie ausrechnen. Genau so wird unser FEM-Programm die Knoten behandeln.
Den Mittelwert einer Liste haben wir oben mit einer Schleife ausgerechnet. Wollen wir das an mehreren Stellen tun, müssten wir die Schleife jedes Mal neu hinschreiben. Besser ist es, sie einmal unter einem Namen aufzuschreiben und diesen Namen dann beliebig oft zu benutzen. So ein benannter Rechenweg heißt Funktion.
Eine Funktion ist wie ein Rezept mit einem Namen: Vorne kommen die Zutaten hinein (die Argumente), hinten kommt ein Ergebnis heraus (das, was hinter return steht). Einmal aufgeschrieben, kann man es immer wieder „kochen”, mit verschiedenen Zutaten. Man schreibt eine Funktion mit dem Schlüsselwort def (von englisch define, festlegen):
def mittelwert(werte):
    """Berechnet den Mittelwert einer Liste von Zahlen.

    werte: eine Liste mit mindestens einer Zahl.
    Rueckgabe: die Summe aller Eintraege geteilt durch ihre Anzahl.
    """
    summe = 0.0
    for wert in werte:
        summe = summe + wert
    return summe / len(werte)
Die erste eingerückte Zeile in dreifachen Anführungszeichen ist der Docstring — eine Kurzbeschreibung im Kopf des Rezepts, die sagt, was die Funktion tut und was hinein- und herauskommt. In diesem Buch bekommt jede Funktion einen Docstring; er ist die Bedienungsanleitung für den nächsten Leser (oft dich selbst in ein paar Wochen).
Aufgeschrieben ist das Rezept noch nichts wert — man muss es aufrufen, also die Zutaten hineingeben:
print(mittelwert(temperaturen))
print(mittelwert([100.0, 200.0, 300.0]))
76.0
200.0Beim ersten Aufruf geben wir unsere Träger-Temperaturen hinein und bekommen die vertrauten 76,0 zurück. Beim zweiten geben wir eine ganz andere Liste hinein und bekommen 200,0 — dieselbe Funktion, andere Zutaten. Das ist die ganze Kraft der Funktion: Einmal richtig gebaut, arbeitet sie für jede Liste.
Funktionen sind die Kapitel eines Programms. So wie dieses Buch die große Aufgabe „FEM verstehen” in Kapitel zerlegt, zerlegt ein gutes Programm seine Arbeit in Funktionen mit sprechenden Namen: baue_elementmatrix, loese_gleichungssystem, mittelwert. Wer die Namen liest, versteht das Programm, ohne jede Zeile zu lesen — und genau so werden wir ab Kapitel 7 die Bausteine unseres FEM-Programms bauen, eine Funktion nach der anderen.
Ein letztes Werkzeug, und es folgt unmittelbar aus dem, was du schon kennst. Eine Liste kann Zahlen enthalten — aber sie kann genauso gut andere Listen enthalten. Eine Liste von Listen ist eine Tabelle: eine Liste von Zeilen, und jede Zeile ist selbst eine Liste von Zellen.
Wir schreiben eine kleine 3×3-Tabelle auf. Die Zahlen darin sind mit Bedacht gewählt — es ist genau die Form, in der ab Kapitel 3 unsere Gleichungssysteme stehen werden:
tabelle = [
    [ 2, -1,  0],
    [-1,  2, -1],
    [ 0, -1,  2],
]

print(tabelle[0])
print(tabelle[0][1])
[2, -1, 0]
-1tabelle[0] holt die erste Zeile heraus — sie ist selbst eine Liste, [2, -1, 0]. Und tabelle[0][1] geht einen Schritt weiter: erst die erste Zeile, davon das Fach [1], also die -1. Zwei Indizes hintereinander, wie Zeile und Spalte in einem Rechenblatt: erst runter zur Zeile, dann rüber zur Spalte. Abbildung 2.4 zeigt das Gitter mit seinen Indizes:
import matplotlib.pyplot as plt

tabelle = [[2, -1, 0], [-1, 2, -1], [0, -1, 2]]
n = 3
fig, ax = plt.subplots(figsize=(5.4, 5.0))
for r in range(n):
    for c in range(n):
        hervor = (r == 0 and c == 1)
        ax.add_patch(plt.Rectangle((c, n - 1 - r), 1, 1,
                                   facecolor="#fff2cc" if hervor else "white",
                                   edgecolor="black", lw=1.3))
        ax.text(c + 0.5, n - 1 - r + 0.5, "%d" % tabelle[r][c], ha="center",
                va="center", fontsize=16)
for i in range(n):
    ax.text(-0.25, n - 1 - i + 0.5, "Zeile [%d]" % i, ha="right", va="center",
            fontsize=11, color="tab:blue", weight="bold")
    ax.text(i + 0.5, n + 0.2, "Spalte [%d]" % i, ha="center", va="bottom",
            fontsize=11, color="tab:red", weight="bold")
ax.set_xlim(-1.7, n + 0.2)
ax.set_ylim(-0.2, n + 0.85)
ax.set_aspect("equal")
ax.axis("off")
plt.tight_layout()
plt.show()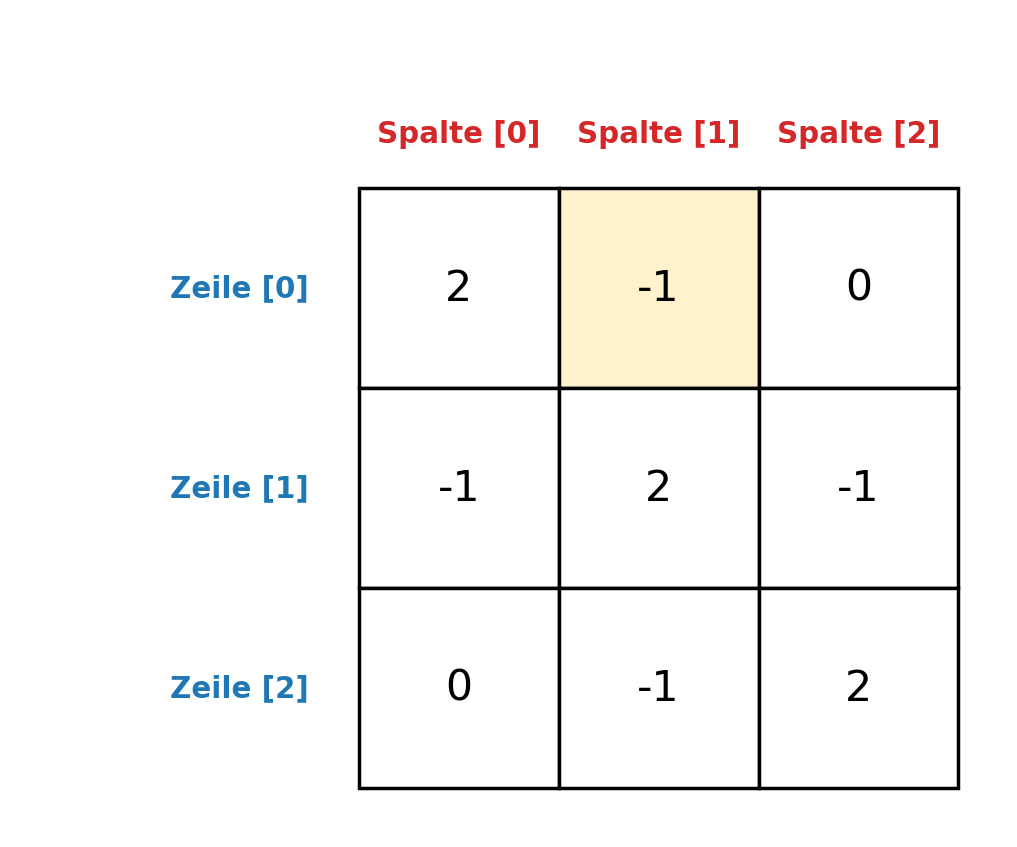
Was man hier sieht: Ein Zahlengitter, in dem jede Zelle über zwei Indizes erreichbar ist — Zeile und Spalte. Das gelb markierte Feld ist tabelle[0][1]. Diese Bauform, eine Liste von Zeilen, ist alles, was man braucht, um eine Matrix im Rechner abzulegen. Und die konkreten Zahlen hier — 2 auf der Mittellinie, −1 daneben, 0 in den Ecken — sind kein Zufall: Es ist die Gestalt, die das Gleichungssystem einer Federkette in Kapitel 3 annimmt. Jede Zahl wird dort sagen, wie stark zwei Knoten zusammenhängen; die Nullen in den Ecken heißen „diese beiden Knoten spüren einander gar nicht”.
Eine Tabelle druckt man mit zwei ineinandergeschachtelten Schleifen: die äußere läuft über die Zeilen, die innere innerhalb einer Zeile über die Spalten.
for zeile in tabelle:
    for zahl in zeile:
        print(f"{zahl:4d}", end="")
    print()
2 -1 0
-1 2 -1
0 -1 2Zwei Kleinigkeiten sind neu. Das Format :4d heißt „vier Zeichen breit, ganze Zahl” (d statt f, weil hier keine Nachkommastellen stehen) — es sorgt wieder für saubere Spalten. Und end="" am Ende von print bedeutet: „mach danach keine neue Zeile auf”. Normalerweise springt print nach jeder Ausgabe in die nächste Zeile; hier aber wollen wir die Zahlen einer Zeile nebeneinander haben. Das leere print() nach der inneren Schleife schließt die Zeile dann ab. So erscheint das Gitter als sauberer Textblock — die Bandstruktur der Matrix wird buchstäblich sichtbar, und genau so werden wir ab Kapitel 3 unsere Gleichungssysteme zu Gesicht bekommen.
Jetzt bist du dran. Die folgenden Zellen laufen in der HTML-Fassung direkt in deinem Browser — du kannst die Zahlen ändern, auf Ausführen drücken und sofort sehen, was herauskommt. Wir bauen die Temperaturtabelle Stück für Stück aus, genau mit den Werkzeugen dieses Kapitels. Vor jeder Zelle steht eine Vorhersage-Frage: Leg dich fest, bevor du ausführst — so merkst du sofort, ob du die Idee schon hast.
Wir starten mit der nackten Liste und drucken jeden Knoten mit seinem Index.
Die erste Modify-Stufe: Mittelwert. Häng ans Ende eine laufende Summe und teile durch die Anzahl.
Die zweite Stufe: Maximum. Wir merken uns den bisher größten Wert und ersetzen ihn, sobald ein größerer auftaucht — genau die Logik, mit der man in einem Stapel Zettel den mit der höchsten Zahl heraussucht.
Die dritte Stufe: schönere Formatierung — die vollständige Tabelle mit Ort und Temperatur, ordentlich in Spalten. Probier ruhig aus, den Brandherd (temperaturen[4]) höher zu stellen oder das Auflager (temperaturen[0]) zu ändern, und schau, wie sich die Tabelle mitbewegt.
Alles, was du hier ausprobiert hast — Liste, Schleife, if, f-String — steckt später Zeile für Zeile im FEM-Programm. Du hast eben seinen Wortschatz gelernt.
Das vollständige, eigenständig lauffähige Skript zu diesem Kapitel liegt in programme/kap02/kap02_temperaturtabelle.py. Es fasst alles zusammen: Es legt die Knotenliste an, druckt die formatierte Tabelle, berechnet mit Funktionen den Mittelwert und findet den wärmsten Knoten — reine Textausgabe, kein Bild. Sein Kern sind genau die Funktionen und Schleifen dieses Kapitels; wer das Kapitel gelesen hat, versteht jede Zeile. Führe es mit python kap02_temperaturtabelle.py aus und vergleiche seine Ausgabe mit den Tabellen oben.
Zurück: Die drei Regler, an denen du in Kapitel 1 gedreht hast, sind nichts anderes als Variablen wie BRANDGAS_TEMPERATUR_GRAD — du hast dort schon Werte gesetzt, ohne es Programmieren zu nennen.
Vor: Die Liste wird zum ständigen Begleiter — sie hält überall die Knotenwerte, ob Temperatur, Verschiebung oder Kraft. Die verschachtelte Liste wird ab Kapitel 3 zur Matrix, dem Herzstück jedes Gleichungssystems; ihr strukturiertes Ausdrucken (Kapitel 4) macht die Bandstruktur sichtbar. Und die Funktionen werden ab Kapitel 7 zu den Bausteinen des FEM-Programms: baue_elementmatrix, loese_gleichungssystem, ein Rezept nach dem anderen, bis im Finale (Kapitel 15) alle zusammenspielen.
Ü 2.1 (Verstehen). Lies die folgenden drei Stücke, ohne sie auszuführen, und sag jeweils vorher, was gedruckt wird.
werte = [3.0, 7.0, 2.0]
print(werte[0] + werte[2])
summe = 0.0
for zahl in [10.0, 20.0, 30.0]:
summe = summe + zahl
print(summe)temperaturen = [20.0, 20.0, 20.0, 20.0, 300.0]
print(len(temperaturen))
print(temperaturen[len(temperaturen) - 1])5.0 — werte[0] ist 3,0 und werte[2] ist 2,0 (das dritte Fach, denn gezählt wird ab 0); zusammen 5,0.
60.0 — die laufende Summe zählt 10, dann 30, dann 60 hoch.
Erst 5 (die Liste hat fünf Fächer), dann 300.0 — das letzte Fach temperaturen[4], der Knoten am Brandherd.
Ü 2.2 (Verändern). Erweitere die Temperaturtabelle aus der interaktiven Einheit um eine vierte Spalte „Abstand zum Brandherd”. Der Brandherd sitzt am rechten Ende (Ort 1,00 m), der Abstand eines Knotens ist also 1.0 - ort_m. Welche Zahl steht in dieser Spalte bei Knoten [0], welche bei Knoten [4]?
In der Schleife eine Zeile ergänzen und die neue Spalte drucken:
for index in range(len(temperaturen)):
    ort_m = index * abstand_m
    abstand_brandherd_m = 1.0 - ort_m
    print(f"  [{index}]  |  {ort_m:4.2f}   | {temperaturen[index]:6.1f} °C"
          f" | {abstand_brandherd_m:5.2f} m")
Bei Knoten [0] (am Auflager) steht 1,00 m, bei Knoten [4] (am Brandherd) 0,00 m — der Knoten am Brandherd hat den Abstand null zu sich selbst.
Ü 2.3 (Übertragen). Schreibe eine Funktion waermster_knoten(temperaturen), die beides zurückgibt: den Index des wärmsten Knotens und seinen Wert. (Tipp: Eine Funktion kann mit return index, wert zwei Dinge auf einmal zurückgeben.) Rufe sie mit der Trägerliste auf und drucke ein Ergebnis wie „Wärmster Knoten: [4] mit 300.0 °C”. Das vollständige Lösungsskript liegt in loesungen/kap02_ue3.py.
def waermster_knoten(temperaturen):
    """Sucht den waermsten Knoten einer Temperaturliste.

    temperaturen: Liste der Knotentemperaturen.
    Rueckgabe: Index des waermsten Knotens und seine Temperatur.
    """
    waermster_index = 0
    for index in range(len(temperaturen)):
        if temperaturen[index] > temperaturen[waermster_index]:
            waermster_index = index
    return waermster_index, temperaturen[waermster_index]


temperaturen = [20.0, 20.0, 20.0, 20.0, 300.0]
index, wert = waermster_knoten(temperaturen)
print(f"Wärmster Knoten: [{index}] mit {wert:.1f} °C")
Ausgabe: Wärmster Knoten: [4] mit 300.0 °C. Die Funktion merkt sich den bisher wärmsten Index und ersetzt ihn, sobald ein größerer Wert auftaucht — dieselbe Logik wie beim Maximum in der interaktiven Einheit, nur gibt sie zusätzlich den Ort zurück.
Dieses Kapitel hat Python bewusst klein gehalten. Es gibt vieles, was die Sprache noch kann — und was du hier absichtlich nicht gesehen hast, weil das Buch es nicht braucht: keine „Klassen”, keine „Dictionaries”, keine trickreichen Einzeiler, kein NumPy. Wir haben for-Schleifen benutzt, aber keine while-Schleifen; wir haben Listen von Hand gefüllt, statt sie mit „Comprehensions” in einer Zeile zu erzeugen. Das ist Absicht und folgt der Regel des ganzen Buches: reines, ehrliches Python, in dem du jede Zeile lesen kannst und die Mathematik eins zu eins wiederfindest (die Schleife ist die Summe, die Liste ist der Vektor, die verschachtelte Liste ist die Matrix). Erfahrene Programmierer würden manches kürzer schreiben — kürzer ist hier aber nicht das Ziel. Verständlich ist das Ziel. Mit genau diesem Werkzeugkasten bauen wir ab Kapitel 3 die komplette FEM-Maschinerie.